長期間のデータを保存する際、HDDの「ビットロット」という現象は決して無視できないリスクです。
磁気ディスクに記録されたデータが、時間の経過や環境要因によって自然に劣化し、1ビットずつ情報が変化してしまうこの問題は、気づかないうちにファイル破損を招く恐れがあります。
特に写真や動画などの大切なデータをアーカイブ目的で保管している方にとって、ビットロットは深刻な脅威となり得ます。
データの破損は必ずしも目に見える形で現れるわけではなく、静かに進行するのがこの問題の恐ろしいところです。
本記事では、ビットロットの仕組みから実践的な対策、そしてファイル破損の兆候を早期に発見するための具体的なチェック方法について解説いたします。
以下のポイントを押さえておくことで、大切なデータを長期にわたって安全に守ることが可能です。
- ビットロットの発生メカニズムとHDDの物理的な特性の関係
- 定期的なデータ検証(スクラビング)の実施方法
- エラーログの監視と異常検知のポイント
- 冗長性を確保するRAIDやバックアップ戦略の重要性
- ファイル整合性チェックツールの活用方法
データ保全は、問題が発生してからでは手遅れになりがちです。
日頃からの予防的なアプローチこそが、長期的なデータの信頼性を担保する最も効果的な手段となります。
それでは、具体的な対策を見ていきましょう。
ビットロットとは?HDDでデータが静かに破損する仕組み
長期間データを保存していると、思いもよらない形でファイルが破損してしまうことがあります。
これが「ビットロット」と呼ばれる現象です。
ビットロットとは、保存されているデータの1ビットや数ビットが、何らかの要因によって自然に反転してしまう現象のことです。
目に見えない磁気の世界で起こるこの変化は、一見すると気づきにくく、気づいたときにはすでに手遅れというケースも少なくありません。
HDDは磁気を利用してデータを記録するデバイスですが、この磁気記録は決して永遠に安定しているわけではありません。
時間の経過とともに磁気の向きが微妙に変化し、本来の0と1の情報が反転してしまうのです。
この現象は、SSDなどの半導体メモリにおいても「セル漏れ」という形で発生するため、ストレージメディア全般に共通するリスクと言えます。
ただし、HDDの場合は磁気的な性質が関わるため、環境条件の影響を特に受けやすいという特徴があります。
ビットロットが発生しても、必ずしも即座にファイルが開けなくなるわけではありません。
場合によっては、写真の一部にノイズが入る、動画の数秒間が乱れる、文書の一部文字が化けるといった形で、部分的な破損として現れることもあります。
これが逆に危険で、気づかないうちに破損が進行し、最終的に復元不可能な状態に陥ってしまうこともあるのです。
ビットロットが起こる原因とHDDの物理的な限界
ビットロットの主な原因は、HDDの物理的な特性に根ざしています。
まず第一に、磁気記録の熱揺らぎが挙げられます。
磁気は温度の影響を受けやすく、長期間高温環境に置かれたHDDでは、磁気粒子の向きが徐々に変化しやすくなります。
これは「スーパーパラマグネティック限界」という現象とも関連しており、記録密度が高くなるほど磁気の安定性は相対的に低下する傾向があります。
第二に、外部磁場の影響も無視できません。
HDDは磁気を利用するデバイスである以上、周囲の磁気的な環境に敏感です。
強い磁気を帯びた機器の近くに長期間置くことや、地震などによる物理的な衝撃が磁気記録に悪影響を与える可能性があります。
また、HDD内部の磁気ヘッドのわずかな位置ずれや、プラッタ表面の微細な傷も、読み出しエラーを引き起こす要因となり得ます。
第三に、経年劣化そのものが問題となります。
HDDの部品は機械的な構造を持っており、潤滑剤の劣化やベアリングの摩耗など、時間とともに物理的な性能が低下します。
これにより、正確な読み書きが困難になり、読み出し時にエラー訂正処理が頻発するようになります。
エラー訂正は一定の範囲内で機能しますが、その限界を超えるとビットロットとして顕在化します。
HDDの物理的な限界を理解することは、適切な保存戦略を立てる上で不可欠です。
以下に、主要な要因とその影響度をまとめます。
| 要因 | 影響の度合い | 対策の優先度 |
|---|---|---|
| 熱揺らぎ・高温環境 | 高 | 優先的に対応 |
| 外部磁場・衝撃 | 中〜高 | 保管環境の見直し |
| 経年劣化・機械的摩耗 | 中 | 定期的な交換計画 |
| 記録密度の高さ | 中 | メディア選定時に考慮 |
ファイル破損の兆候を見逃さないチェック方法とは
ビットロットは静かに進行するため、日常的にファイルを開く機会が少ないアーカイブデータでは、破損に気づくのが遅れがちです。
そこで、定期的な整合性チェックを習慣化することが重要です。
まず、ファイルを開いた際に異常がないか確認することは基本ですが、それだけでは不十分です。
より確実な方法として、以下のチェック方法を推奨いたします。
- ファイルのハッシュ値(チェックサム)を保存時に記録し、定期的に再計算して比較する
- OSや専用ツールのエラーログを定期的に確認し、読み出しエラーの有無を監視する
- 画像や動画ファイルの場合、サムネイル表示やプレビューで異常がないか目視確認する
- 重要な文書ファイルは、バージョン管理や差分確認ツールで変更点を追跡する
特にハッシュ値の管理は、ビットロットの有無を客観的に判断できる非常に有効な手段です。
SHA-256やMD5などのアルゴリズムを用いてファイル固有のハッシュ値を算出し、これを安全な場所に保管しておきます。
一定期間ごとに同じファイルのハッシュ値を再計算し、元の値と比較することで、1ビットの変化であっても確実に検出できます。
また、OSが出力するシステムログやSMART情報の監視も見逃せません。
WindowsのイベントビューアーやLinuxのsyslog、dmesgなどから、ディスク関連のエラーや警告を抽出することで、HDDの健康状態を把握できます。
SMART属性の「Reallocated Sector Count」や「Current Pending Sector Count」などの値が増加している場合は、物理的な劣化が進行している兆候であり、早急な対応が必要です。
ファイル破損の兆候は、必ずしも目立つ形で現れるわけではありません。
日頃からの監視と、予防的なチェック体制の構築こそが、長期保存におけるデータ保全の鍵となります。
次の章では、これらのチェックをより体系的に実践する「データスクラビング」について解説いたします。
データスクラビングで定期的に整合性を確認する方法
ビットロットは静かに進行するため、日常的なファイルの閲覧だけでは早期発見が困難です。
そこで有効なのが、データスクラビングと呼ばれる定期的な整合性確認の仕組みです。
スクラビングとは、保存されているデータを順次読み出し、記録されているパリティ情報やチェックサムと照合することで、データの破損や矛盾を検出する処理のことです。
これを定期的に実行することで、ビットロットの兆候を早期に捉え、修復可能な段階で対処できます。
HDD単体でのスクラビングと、RAIDやNASなどの冗長構成でのスクラビングでは、役割と効果が異なります。
HDD単体の場合、主に読み出しエラーの検出と、SMART情報の更新が期待できます。
一方、RAID構成では、各ドライブのデータを相互に照合し、不整合があれば冗長情報を用いて自動修復する機能が働きます。
このため、冗長構成を採用している環境では、スクラビングの重要性がさらに高まります。
スクラビングの頻度については、用途やデータの重要度によって調整するのが妥当です。
アーカイブ用途のHDDであれば、月に1回程度のスクラビングを推奨します。
頻繁にアクセスされるデータであれば、読み出しエラーが即座に検出される可能性が高いため、四半期に1回程度でも十分な場合があります。
ただし、長期間電源を入れていない外付けHDDなどは、使用前にスクラビングを実行し、データの健全性を確認してからアクセスするのが賢明です。
スクラビングツールの選び方とおすすめソフトウェア
スクラビングツールを選ぶ際には、使用環境と目的に応じた選択が重要です。
まず、OS標準のツールから導入を検討するのが効率的です。
Windowsでは、Storage SpacesやReFSの整合性スキャン機能が利用できます。
Linux系では、smartctlコマンドを用いたSMARTテストや、ファイルシステムレベルのチェックとしてfsck、e2fsckなどが広く使われています。
より高度なスクラビングが必要な場合は、専用ソフトウェアの導入を検討してください。
以下に、主要なツールとその特徴をまとめます。
| ツール名 | 対応OS | 主な特徴 | 推奨用途 |
|---|---|---|---|
| smartmontools | Linux/Windows/macOS | SMART情報の詳細監視とテスト実行 | HDDの健康状態管理 |
| SpinRite | Windows(ブート可) | 低レベルでの磁気記録のリフレッシュ | 深刻な読み出しエラー対策 |
| badblocks | Linux | ブロック単位の不良セクター検出 | Linux環境での診断 |
| CrystalDiskInfo | Windows | 視覚的なSMART監視と警告機能 | 日常的な状態確認 |
| Unraid / TrueNAS | 専用OS | ファイルシステム統合型スクラビング | NAS環境での自動運用 |
NAS環境を利用している場合は、Synology DSMやQNAP QTSなどのOSに搭載されたスクラビング機能が最も手軽です。
これらは定期的なスケジュール実行に対応しており、管理者の手間を大幅に削減できます。
特にZFSやBtrfsを採用したNASでは、チェックサムベースのスクラビングが標準で利用でき、ビットロットの検出精度が高いのが強みです。
ツール選定の際には、データの重要性と運用コストのバランスを考慮してください。
無料ツールで十分な場合もあれば、業務用途では有償ソフトウェアの導入が合理的な場合もあります。
スマートコマンドによる自動化とスケジュール設定のポイント
スクラビングの効果を最大化するには、人手に依存しない自動化が不可欠です。
定期的な実行を忘れがちな作業ですから、システムに任せることで運用の抜け漏れを防げます。
Linux環境では、cronを利用したスケジュール設定が一般的です。
例えば、毎月第1日曜日の深夜にsmartctlの長時間テストを実行するといった設定が可能です。
自動化にあたっては、以下のポイントに留意してください。
- スクラビング実行中のディスク負荷を考慮し、業務時間外やアクセスが少ない時間帯にスケジュールする
- 実行結果をログに残し、エラー発生時にはメールや通知で管理者にアラートを送る仕組みを構築する
- 複数ドライブを同時にスクラビングするとI/O負荷が集中するため、時間をずらして順次実行する
- スクラビング前にバックアップを取得しておき、万が一の事態に備える
Windows環境では、タスクスケジューラを利用して同様の自動化が実現できます。
PowerShellスクリプトと組み合わせることで、smartctlの実行から結果の解析、異常検知時の通知までを一連のフローとして構築できます。
企業環境では、監視ツールとの連携も検討に値します。
ZabbixやNagiosなどの監視システムにSMART情報を連携させ、閾値を超えた際に自動アラートを発報する仕組みを作ることで、より確実な運用が可能です。
自動化の本質は、人間の記憶や判断に依存しない信頼性の確保にあります。
一度設定を完了させれば、日々の業務に支障をきたすことなく、バックグラウンドでデータの健全性が監視され続けます。
ただし、自動化したからといって完全に放置するのは避け、定期的にログを確認し、スクラビングの実行状況を把握する習慣は維持してください。
データスクラビングは、ビットロット対策の中核をなす予防的な取り組みです。
適切なツール選定と効果的な自動化により、長期保存におけるデータの信頼性を大幅に向上させることができます。
次の章では、冗長性を確保するRAID構成について解説いたします。
RAID構成で冗長性を確保しビットロットに備える
データの長期保存において、単一のHDDに依存する構成は、ビットロットやハードウェア故障のリスクをそのまま受け入れる形になります。
そこで有効なのが、複数のドライブを組み合わせて冗長性を確保するRAID構成です。
RAIDはRedundant Array of Independent Disksの略称であり、複数の物理ドライブを論理的に1つのストレージとして扱う技術です。
適切なRAIDレベルを選択することで、ビットロットの検出と修復、およびドライブ故障時のデータ保護を両立させることが可能です。
RAIDには複数のレベルが存在し、それぞれ性能、可用性、容量効率のトレードオフが異なります。
データ保全を重視するのであれば、冗長性を持つRAID1やRAID5、RAID6などの構成が適しています。
これらの構成では、1台以上のドライブが故障してもデータが失われない仕組みが備わっており、さらにスクラビング機能と組み合わせることで、ビットロットによる静かなデータ破損も検出・修復できます。
RAIDを導入する際の注意点として、ハードウェアRAIDとソフトウェアRAIDの違いを理解しておく必要があります。
ハードウェアRAIDは専用コントローラーが処理を担当し、OSからは独立して動作します。
一方、ソフトウェアRAIDはOSやファイルシステムが冗長処理を行う方式で、ZFSやBtrfsのRAID機能、Linuxのmdadmなどが該当します。
近年では、ZFSのようなファイルシステム統合型のソフトウェアRAIDが、チェックサムによるビットロット検出能力の高さから注目を集めています。
RAID1とRAID5の違いとデータ保護の強度比較
RAID1とRAID5は、いずれも冗長性を持つ代表的なRAIDレベルですが、データ保護の仕組みと特性に大きな違いがあります。
RAID1はミラーリングと呼ばれる方式で、2台以上のドライブに全く同じデータを複製して記録します。
1台のドライブが故障しても、残りのドライブからデータを読み出せるため、可用性は非常に高いです。
ビットロット対策としても、複数のドライブから読み出したデータを比較することで不整合を検出できるという利点があります。
RAID5は、パリティ分散という方式を採用しています。
データとともに誤り訂正符号(パリティ)を複数のドライブに分散して記録し、1台のドライブが故障してもパリティ情報からデータを復元できます。
RAID5の強みは、RAID1に比べて容量効率が良い点です。
例えば4台のドライブでRAID5を構成した場合、総容量の約3/4をデータ領域として利用できます。
一方、RAID1では2台構成で1/2、4台構成でも1/2の容量しかデータ領域として使えません。
以下に、RAID1とRAID5の主な違いをまとめます。
| 項目 | RAID1(ミラーリング) | RAID5(パリティ分散) |
|---|---|---|
| 最低必要ドライブ数 | 2台 | 3台 |
| 許容できる故障台数 | 1台 | 1台 |
| 容量効率 | 約50%(2台時) | 約67〜93%(3台以上) |
| 書き込み性能 | 良好 | パリティ計算によりやや低下 |
| ビットロット検出 | ドライブ間比較で可能 | パリティ照合で可能 |
| 再構築時の負荷 | 比較的低い | 高負荷で他のドライブに負担 |
RAID5の弱点として、再構築中に別のドライブが故障するとデータが失われるリスクがあります。
これを補うために、2台までの故障に耐えられるRAID6も広く利用されています。
RAID6はパリティ情報を2重に持つため、大規模なストレージ環境ではより安心感があります。
RAIDレベルの選定は、保存するデータの重要性、予算、許容できる容量ロスを総合的に勘案して行うのが適切です。
個人利用で重要なデータを守るのであればRAID1のシンプルさが魅力ですし、中規模のNAS環境ではRAID5やRAID6がバランスの取れた選択となります。
RAIDは万能ではない?バックアップとの併用が重要な理由
RAID構成は確かにデータ保護の強力な手段ですが、万能の解決策ではありません。
RAIDは主にハードウェア故障と一部のビットロットに対する耐性を提供しますが、それ以外のリスクをカバーするわけではありません。
例えば、以下のような事態はRAIDだけでは防げません。
- ランサムウェアなどの悪意あるソフトウェアによるデータの暗号化や破壊
- 人為的な誤操作によるファイルの削除や上書き
- 電源障害やOSクラッシュによるファイルシステムの破損
- 全ドライブ同時故障や自然災害による物理的な破壊
- ビットロットが全ドライブの同一セクタに発生した場合の検出困難
これらのリスクに対処するためには、RAIDとバックアップを併用する必要があります。
RAIDは可用性と耐障害性を高める仕組みであり、バックアップは異なる時点のデータのスナップショットを保持する仕組みです。
両者の役割は根本的に異なり、相互に補い合う関係にあります。
具体的な運用としては、RAID構成のNASをプライマリストレージとして利用し、別媒体(外付けHDDやクラウドストレージ)に定期的にバックアップを取得するという形が推奨されます。
バックアップには、世代管理を取り入れることで、過去の状態に遡って復元できる柔軟性も確保できます。
これにより、ランサムウェア被害を受けた場合でも、感染前のバックアップから復旧することが可能です。
RAIDとバックアップの併用は、多層防御の考え方に基づいています。
単一の防御線に依存せず、複数の層でリスクを低減することで、総合的なデータ保全の信頼性を高めます。
投資コストや管理工数は増えますが、長期的に大切なデータを守るのであれば、この投資は十分に価値のあるものです。
RAID構成の導入は、ビットロット対策の重要な一環ですが、それだけに依存しない冷静な判断が求められます。
次の章では、ファイルの完全性をハッシュ値で保証する方法について解説いたします。
ハッシュ値チェックでファイルの完全性を保証する
データスクラビングやRAID構成は、ストレージシステムレベルでのビットロット対策として効果的です。
しかし、個別のファイル単位で完全性を確認したい場合、より直接的な手段が必要となります。
そこで役立つのが、ハッシュ値チェックです。
ハッシュ値は、ファイルの内容に基づいて算出される固定長の数値であり、ファイルの1ビットでも変化すれば、算出されるハッシュ値も完全に異なる値になります。
この性質を利用することで、ファイルがビットロットなどによって改変されていないかを客観的に検証できます。
ハッシュ値の利用は、デジタル署名やパッケージの改竄検知など、セキュリティ分野で広く使われている技術です。
データ保全の文脈では、保存時にハッシュ値を記録しておき、後日同じファイルのハッシュ値を再計算して比較することで、静かなデータ劣化を検出するという使い方が一般的です。
特に写真や動画などの大切なアーカイブデータに対して、この方法を適用することで、長期間の保存における安心感を得ることができます。
ハッシュ値チェックの利点は、ファイルシステムやストレージ構成に依存しない点です。
外付けHDD、USBメモリ、クラウドストレージなど、あらゆる保存媒体に対して同じ方法論を適用できます。
また、ハッシュ値そのきは極めて小さなデータ量であるため、元のファイルとは別の安全な場所に保管しておくことも容易です。
これにより、ハッシュ値自体も一緒に破損するというリスクを回避できます。
SHA-256やMD5ハッシュの計算方法と実践手順
ハッシュアルゴリズムには複数の種類がありますが、データ保全の目的では、SHA-256が現在最も推奨される選択です。
MD5は計算速度が速いものの、衝突攻撃に対する脆弱性が指摘されており、厳密な完全性保証には不向きです。
SHA-256は、現時点で実用的な攻撃手法が知られていない堅牢なアルゴリズムであり、十分な安全性と計算効率のバランスを持っています。
各OSでのハッシュ値計算方法は以下の通りです。
Windows環境では、PowerShellを利用するのが最も手軽です。
Get-FileHashコマンドレットを使うことで、簡単にSHA-256ハッシュ値を取得できます。
コマンドプロンプトからでもCertUtilツールを使えば同様の計算が可能です。
macOSやLinuxでは、標準でインストールされているsha256sumコマンドを利用します。
これらのコマンドは、単一ファイルだけでなく、ディレクトリ内の複数ファイルに対して一括処理することも可能です。
具体的な実践手順としては、まず保存したいファイルのハッシュ値を計算し、ファイル名とともにテキストファイルやデータベースに記録します。
記録形式は簡素なCSVでも構いませんし、sha256sumの標準出力形式をそのまま保存しておくのも便利です。
一定期間後、同じファイルに対してハッシュ値を再計算し、保存していた値と照合します。
一致していればファイルは無事であり、不一致であればビットロットや改竄の疑いがあります。
以下に、主要なOSでのSHA-256計算コマンドをまとめます。
| OS | コマンド | 出力形式 |
|---|---|---|
| Windows (PowerShell) | Get-FileHash -Algorithm SHA256 ファイルパス |
Hashプロパティに表示 |
| Windows (CMD) | certutil -hashfile ファイルパス SHA256 |
16進数文字列出力 |
| macOS | shasum -a 256 ファイルパス |
ハッシュ値とファイル名 |
| Linux | sha256sum ファイルパス |
ハッシュ値とファイル名 |
大量のファイルを扱う場合は、スクリプト化して自動化することを推奨します。
Pythonのhashlibモジュールや、シェルスクリプトを利用すれば、数千ファイルのハッシュ値計算と比較を効率的に行えます。
ハッシュデータベースの管理と定期的な照合運用
ハッシュ値の記録は、体系的な管理がなければ意味をなしません。
ファイルが増えればハッシュ値も比例して増加するため、管理方法を事前に設計しておく必要があります。
最もシンプルな方法は、sha256sumの出力をそのままテキストファイルに保存する方式です。
ファイル名とハッシュ値が1行にまとまって出力されるため、後からのgrep検索も容易です。
より高度な管理が必要な場合は、専用のデータベースやスプレッドシートを利用するのが効果的です。
管理項目としては、ファイルパス、ハッシュ値、計算日時、ファイルサイズなどを記録しておくと、後の調査に役立ちます。
特に、計算日時は重要なメタデータです。
何時点でハッシュ値が正常であったかを記録しておくことで、破損が発生した期間の特定が可能になります。
定期的な照合運用の頻度は、データの重要度と変更頻度によって調整するのが適切です。
アーカイブデータであれば、半年に1回程度の照合で十分な場合が多いです。
頻繁にアクセスされるデータや、重要度の高いデータについては、四半期ごとや月次での照合を検討してください。
照合の結果、不一致が検出された場合の対応フローも事前に決めておくべきです。
- 不一致が検出されたら、まず他のバックアップから同ファイルのハッシュ値を確認する
- バックアップ側のハッシュ値が正常であれば、破損したファイルをバックアップから復元する
- 全てのバックアップで不一致の場合は、ファイルの重要度を考慮して復旧の優先順位を決定する
- 破損の原因を調査し、ストレージ環境の見直しや交換を検討する
ハッシュデータベース自体も、改竄や破損から保護する必要があります。
ハッシュ値ファイルを、元のデータとは別の媒体やクラウドストレージに保管することで、同時被害のリスクを低減できます。
また、ハッシュ値ファイル自体のハッシュ値を上位層で管理するという、入れ子構造のアプローチも、より厳密な完全性保証には有効です。
ハッシュ値チェックは、ファイルレベルでのビットロット検出において、最も確実で汎用性の高い手法です。
適切な運用設計と継続的な実行により、長期保存におけるデータの完全性を強固に保証することができます。
次の章では、外付けHDDやNASでの長期アーカイブの注意点について解説いたします。
外付けHDDやNASでの長期アーカイブにおける注意点
デジタルデータの長期保存を検討する際、外付けHDDやNASは最も身近で実用的な選択肢として挙げられます。
しかし、これらのデバイスを単に接続して放置するだけでは、ビットロットや故障のリスクを十分に低減できません。
長期アーカイブにおいては、デバイスの特性を理解した上で、適切な運用と環境管理を行う必要があります。
特に外付けHDDは、内蔵HDDと比較して通気性や熱対策が弱いケースが多く、温度管理の重要性が高まります。
NASは複数のドライブを搭載し、RAID構成やスクラビング機能を備えた統合ストレージシステムです。
個人利用から中小規模の業務利用まで幅広く対応しており、長期アーカイブの中核として適しています。
ただし、NASも万能ではなく、適切な設定と定期的なメンテナンスが欠かせません。
電源を入れっぱなしにしておけば自動的にデータが守られるというわけではなく、各種機能を有効化し、運用状況を監視することが求められます。
外付けHDDとNASの使い分けについては、データへのアクセス頻度と重要度を基準に検討すると良いでしょう。
頻繁に参照しない冷データであれば、外付けHDDに保存して適切な環境で保管する方法も有効です。
一方、定期的にアクセスするデータや、家族・チームで共有するデータであれば、NASによる集中管理が適しています。
いずれの場合も、単一のデバイスに依存せず、バックアップを別媒体に取るという原則は変わりません。
アーカイブ用HDDの保管環境と温度・湿度管理
HDDは磁気記録を利用するデバイスであるため、環境条件の影響を受けやすい性質があります。
特に温度と湿度は、データの長期保存において最も重要な管理項目です。
メーカーの推奨動作環境は一般的に、温度5℃から55℃、相対湿度20%から80%程度ですが、長期保存を考慮するなら、より厳格な範囲内に収めるのが望ましいです。
高温環境は、磁気記録の劣化を加速させます。
熱揺らぎが増大し、磁気粒子の向きが不安定になりやすくなるため、ビットロットの発生リスクが高まります。
一方、低温環境でも問題はあります。
極端に低温になると、HDD内部の潤滑剤が粘度を増し、ベアリングの回転が不安定になる可能性があります。
また、温度の急激な変化は結露を引き起こし、HDD内部に水分が侵入して故障の原因となることもあります。
湿度管理も同様に重要です。
高湿環境では、HDDの基板やコネクタの腐食が進行し、電気的な接触不良を招きます。
低湿環境では、静電気の発生が増加し、HDDにダメージを与える可能性があります。
理想的な保存環境は、温度15℃から25℃、相対湿度40%から50%程度とされています。
この範囲を維持できる場所を選び、温度計と湿度計を設置して常時監視することを推奨します。
外付けHDDの保管にあたっては、以下のポイントに留意してください。
- 直射日光や熱源の近く、エアコンの風が直接当たる場所は避ける
- 通気性の良い場所に置き、本体の放熱を妨げない
- 複数の外付けHDDを重ねて置く場合は、熱がこもらないように間隔を空ける
- 長期間使用しない場合でも、半年に1回程度は電源を入れてデータを読み出す(リフレッシュ)
- 静電気防止対策として、導電性のマットや袋を利用する
外付けHDDを使用する際の注意点として、USB接続の安定性も見逃せません。
劣化したUSBケーブルや、電力供給が不安定なUSBハブを使用すると、書き込み中に接続が切断され、ファイルシステムが破損するリスクがあります。
品質の高いケーブルと、十分な電力供給ができる接続環境を確保してください。
NASのスクラビング機能と自動エラー検出の設定
NASは、長期アーカイブの中核として優れた機能を持っていますが、その真価を発揮するには適切な設定が不可欠です。
特に重要なのが、スクラビング機能の有効化と自動エラー検出の設定です。
主要なNASメーカーのOSには、これらの機能が標準で搭載されており、有効にすることでビットロットの早期発見と修復が可能になります。
Synology DSMの場合、「ストレージマネージャー」から「データ整合性保護」機能を有効にできます。
これはBtrfsファイルシステムのチェックサム機能を利用したもので、スクラビング実行時にデータの整合性を検証します。
設定画面からスクラビングのスケジュールを設定し、月次や四半期ごとの自動実行を構成できます。
実行結果は通知センターに表示され、異常が検出された場合はメールやプッシュ通知でアラートを受け取ることが可能です。
QNAP QTSの場合も同様に、「ストレージとスナップショット」からスクラビングの設定を行えます。
QTSでは、RAIDグループのスクラビングと、ファイルシステムレベルのスキャンを個別に設定できます。
両方を有効にすることで、より多層的なデータ保護を実現できます。
NASのスクラビング設定における推奨事項は以下の通りです。
- スクラビングは業務時間外や深夜にスケジュールし、通常のアクセスに影響を与えないようにする
- スクラビングの実行結果ログを定期的に確認し、エラーの有無を把握する
- 通知設定を有効にし、異常検出時に即座に管理者に通知する仕組みを構築する
- スクラビングと並行して、SMARTテストも定期的に実行する
- 新しいドライブを追加した場合や、RAID再構築後には、手動でスクラビングを実行して整合性を確認する
NASの自動エラー検出機能は、日常の監視負担を大幅に軽減してくれます。
ただし、通知を有効にしても、それを見落とすことは十分にあり得ます。
通知先を複数設定したり、重要なアラートを別途監視システムに連携したりすることで、見逃しのリスクを低減できます。
NASの運用においても、RAID構成の限界を理解しておく必要があります。
RAIDはドライブ故障に対する耐性を提供しますが、ファイルの誤削除やランサムウェアには無力です。
NASに保存したデータも、別媒体へのバックアップを併用することで、より確実な保護を実現してください。
外付けHDDとNASは、それぞれの特性を活かしつつ適切に運用することで、長期アーカイブの強力な基盤となります。
次の章では、クラウドストレージとの併用について解説いたします。
クラウドストレージとの併用で最終防衛ラインを構築する
ローカルストレージによる対策は、ビットロットやハードウェア故障のリスクを大幅に低減できます。
しかし、自然災害や盗難、火災などの物理的な脅威からは、どうしても完全に守ることが困難です。
そこで、地理的に離れた場所にデータを保管できるクラウドストレージとの併用が、最終防衛ラインとして極めて有効となります。
クラウドストレージは、データセンター側で冗長化や整合性チェックが行われるため、単一のローカルデバイスに比べて耐障害性が高いという強みを持っています。
クラウドストレージをバックアップ用途で利用する場合、単なるファイル同期サービスとの違いを理解しておく必要があります。
DropboxやGoogle Driveなどの同期型サービスは、ローカルファイルの変更をリアルタイムで反映するため、誤削除やランサムウェアの被害も即座にクラウド側に伝播してしまいます。
一方、バックアップ専用のクラウドサービスは、バージョン管理や不変性(イミュータビリティ)を備えており、過去の状態に遡って復元できる柔軟性があります。
クラウドストレージの導入を検討する際には、コスト、セキュリティ、アクセス性の3軸でバランスを取るのが重要です。
無料プランでは容量が限定的ですし、有料プランに移行する場合も、長期的な運用コストを見積もっておく必要があります。
また、インターネット回線の速度によっては、大量データのアップロードに相当な時間を要するため、初期導入時の計画も欠かせません。
クラウドバックアップの選び方と暗号化の重要性
クラウドバックアップサービスを選定する際には、単なる容量と価格だけでなく、セキュリティ機能の充実度を重視すべきです。
特に、エンドツーエンド暗号化の有無は、データの機密性を担保する上で最重要のポイントとなります。
エンドツーエンド暗号化が実装されているサービスでは、データはユーザーのデバイス上で暗号化された状態でアップロードされ、クラウドプロバイダー側でも復号鍵を持たないため、第三者によるデータの閲覧が原理的に不可能です。
主要なクラウドバックアップサービスの特徴を以下にまとめます。
| サービス名 | エンドツーエンド暗号化 | バージョン管理 | 主な特徴 |
|---|---|---|---|
| Backblaze | 対応(オプション) | 30日間(延長可) | 無制限バックアップでコストパフォーマンス良好 |
| IDrive | 対応(標準) | 30世代以上 | 複数デバイス同期とバックアップの両対応 |
| pCloud | 対応(Cryptoオプション) | 15日〜30日 | 生涯ライセンスプランあり |
| Tresorit | 対応(標準) | バージョン管理充実 | 企業向けセキュリティ重視 |
| Amazon S3 Glacier | クライアント側暗号化必要 | ライフサイクル管理 | 長期アーカイブに最適な低コスト |
暗号化の方式についても確認が必要です。
AES-256などの業界標準暗号化が採用されているか、暗号化キーの管理方法はどうなっているか、これらは選定時の重要な判断材料です。
サービスが暗号化キーを保持するタイプの場合、法執行機関からの要請などでデータが開示される可能性があることを認識しておくべきです。
バックアップデータの暗号化は、プライバシー保護だけでなく、ビットロット対策の文脈でも意味を持ちます。
暗号化されたデータは、改竄検知の仕組みと組み合わせることで、データの完全性をより確実に検証できます。
暗号化された状態でハッシュ値を管理すれば、転送中や保存中の改変も検出可能です。
クラウドバックアップの運用においては、初期フルバックアップ後の差分・増分バックアップの設定も重要です。
毎回全データをアップロードするのは非効率であるため、変更された部分のみを効率的に同期する設定を行うことで、帯域の節約とバックアップ時間の短縮が実現できます。
3-2-1バックアップルールを実践する具体的な手順
データ保全の世界で広く知られている3-2-1バックアップルールは、長期保存における基本的な指針となります。
このルールは、データを3つ以上のコピーで保持し、2種類以上の異なる媒体に保存し、1つはオフサイト(地理的に離れた場所)に保管するというものです。
この原則に従うことで、単一の故障点や災害によるデータ消失を効果的に防ぐことができます。
具体的な実践手順として、以下の構成を例に挙げます。
- プライマリデータ:NASまたは内蔵HDDに保存されたオリジナルデータ
- ローカルバックアップ:外付けHDDに定期的にバックアップを取得
- クラウドバックアップ:BackblazeやIDriveなどのクラウドサービスに暗号化してアップロード
この構成では、3つのコピー(オリジナル、外付けHDD、クラウド)が存在し、2種類の媒体(HDD、クラウド)を使用し、1つがオフサイト(クラウド)に配置されるため、3-2-1ルールを満たします。
より厳格な保護が必要な場合は、3-2-1-1ルール(もう1つはオフラインまたは不変性を持つコピー)や、3-2-2ルール(2つの異なるクラウドプロバイダー)への拡張も検討できます。
ただし、管理工数とコストが増加するため、データの重要度に応じた段階的な導入が現実的です。
3-2-1ルールの運用における重要なポイントは以下の通りです。
- バックアップの自動化を徹底し、人為的なミスや忘れを排除する
- バックアップのリストアテストを定期的に実施し、復元が確実に行えることを確認する
- バックアップの世代管理を行い、過去の複数の状態を保持できるようにする
- クラウドバックアップの暗号化キーは、サービスとは別の安全な場所に保管する
- バックアップ対象の見直しは定期的に行い、不要なデータの蓄積を防ぐ
クラウドストレージとの併用は、ローカルでの対策だけではカバーしきれないリスクに対する最終防衛ラインです。
適切なサービス選定と、3-2-1ルールに基づいた体系的な運用により、データの長期保存における信頼性を最大限に高めることができます。
次の章では、ファイルシステムの選択がビットロット対策に与える影響について解説いたします。
ファイルシステムの選択がビットロット対策に与える影響
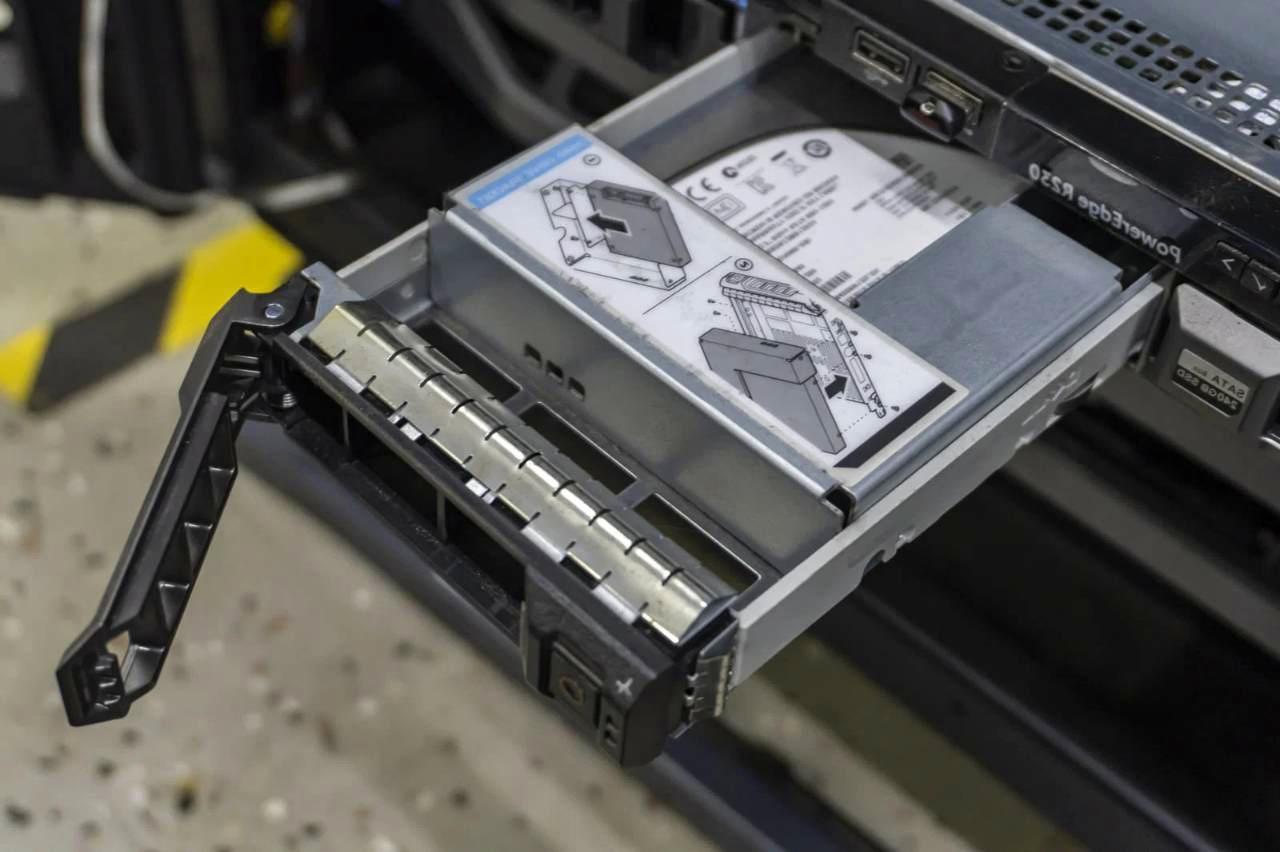
ストレージデバイスやRAID構成、バックアップ戦略といったハードウェア・運用面の対策は重要ですが、データが実際に記録されるファイルシステムの特性も、ビットロット対策において見逃せない要素です。
ファイルシステムは、OSとストレージデバイス間の橋渡しを担う層であり、その設計思想によってデータの完全性を保証する能力は大きく異なります。
適切なファイルシステムを選択することで、ビットロットの検出から修復までをシステムレベルで自動化できるため、長期保存における信頼性は飛躍的に向上します。
従来のファイルシステムは、主に性能と互換性を重視して設計されており、データの完全性検証はストレージデバイス側に委ねる形が一般的でした。
しかし、ストレージ密度の向上に伴い、HDDやSSDにおけるビットロットのリスクは相対的に増大しており、ファイルシステム自体がデータの整合性を積極的に管理する必要性が高まっています。
この背景から、ZFSやBtrfsのような、チェックサムと自己修復機能を内包した次世代ファイルシステムが注目を集めているのです。
ファイルシステムの選定は、使用するOSや用途と密接に関係します。
Windows環境ではNTFSが標準であり、Linux環境ではext4が広く使われています。
これらは安定性と互換性に優れていますが、ビットロット対策の観点からは機能的な限界があります。
一方、ZFSやBtrfsは、データ保全を最優先に設計されたファイルシステムであり、適切な運用により従来のファイルシステムでは実現困難なレベルの保護を提供できます。
ZFSやBtrfsの自己修復機能とデータ保護の強み
ZFSは、Sun Microsystems(現Oracle)によって開発されたファイルシステムで、コピーオンライト(CoW)アーキテクチャと、ブロック単位のチェックサム機能を特徴としています。
ZFSでは、書き込まれる全てのデータブロックに対してチェックサムが計算され、メタデータとともに別の階層に保存されます。
読み出し時には、保存されたチェックサムと実際に読み出したデータのチェックサムを比較し、不一致があれば即座に検出します。
ZFSの最大の強みは、冗長構成(RAID-Z)下で自己修復(self-healing)を自動的に行える点です。
チェックサムの不一致が検出されると、ZFSは冗長情報(ミラーやパリティ)から正しいデータを復元し、破損したブロックを修復します。
この処理は読み出し時に自動的に実行されるため、管理者の介入なしにデータの整合性が維持されます。
さらに、ZFSのスクラブ機能を定期的に実行することで、全データブロックの整合性を能動的に検証・修復できます。
Btrfsも同様に、CoWアーキテクチャとチェックサム機能を備えたファイルシステムです。
Linuxカーネルに統合されており、ZFSに比べてライセンス上の制約が少なく、より広く利用されています。
BtrfsはRAID0/1/5/6/10に対応し、ファイルシステムレベルでの冗長化が可能です。
スクラビング機能も搭載しており、定期的な実行によりビットロットの検出と修復を行えます。
以下に、ZFSとBtrfsの主な特徴を比較します。
| 項目 | ZFS | Btrfs |
|---|---|---|
| チェックサム | ブロック単位(fletcher4, SHA256) | ブロック単位(crc32c, xxhash) |
| 自己修復 | RAID-Z下で自動実行 | RAID下で自動実行 |
| スナップショット | 軽量で高速 | 軽量で高速 |
| RAIDレベル | RAID-Z1/Z2/Z3 | RAID0/1/5/6/10 |
| 圧縮・重複排除 | 標準搭載 | 標準搭載 |
| OS対応 | FreeBSD, Linux, macOSなど | Linuxが中心 |
ZFSやBtrfsの導入には、一定の学習コストとハードウェア要件が伴います。
特にZFSは、推奨されるメモリ容量が比較的大きく、ECCメモリの使用が推奨されるなど、本格的な運用には相応の環境が必要です。
ただし、長期保存におけるデータ保全を最優先するのであれば、この投資は十分に価値のあるものです。
NTFSやext4におけるエラー検出の限界と対処法
NTFSはWindowsの標準ファイルシステムとして広く利用されており、安定性と互換性に優れています。
しかし、NTFSはファイルシステムメタデータの整合性には一定の保護機構を持っていますが、ユーザーデータそのもののチェックサムは管理していません。
つまり、ファイルの内容がビットロットによって変化しても、NTFS自体はそれを検出できないのです。
エラー検出は主に、ジャーナリングによるメタデータの不整合検出と、ストレージデバイス側のECCに依存します。
ext4も同様に、Linuxの標準ファイルシステムとして高い信頼性を誇りますが、ユーザーデータのチェックサム機能は持ち合わせていません。
ext4のジャーナリングは、ファイルシステムの構造的一貫性を保つためのものであり、ファイル内容のビット単位の変化を検出するものではありません。
そのため、ビットロットが発生しても、通常の読み出しでは気づかないまま破損が進行する可能性があります。
NTFSやext4を利用する環境でのビットロット対策としては、以下の方法が有効です。
- ファイル単位でハッシュ値を管理し、定期的に照合する(前章で解説した手法)
- ストレージデバイス側のSMART情報を監視し、読み出しエラーの増加を早期に検知する
- RAID構成を組み合わせ、ハードウェアレベルでの冗長性を確保する
- 定期的なフルバックアップを取得し、世代管理によって過去の正常な状態を保持する
- 可能であれば、ファイルシステム上の圧縮機能を利用し、圧縮ヘッダーの破損検出を補助的に活用する
また、Windows 11以降ではReFS(Resilient File System)が利用できる場合があります。
ReFSはチェックサム機能を持ち、一定の自己修復能力も備えていますが、現時点では一般的なデスクトップ用途よりも、Storage Spacesやサーバー環境での利用が中心となっています。
将来的には、ReFSの普及によりWindows環境におけるビットロット対策も容易になる可能性があります。
ファイルシステムの選択は、長期保存戦略の根幹をなす決定です。
ZFSやBtrfsの導入が現実的であれば、それらの自己修復機能を最大限に活用すべきです。
一方、NTFSやext4を継続して利用する場合は、ファイルシステムの限界を理解した上で、ハッシュ値管理やRAID、バックアップなどの代替手段で補完することが求められます。
次の章では、データ保全運用のスケジュール設計について解説いたします。
定期的なデータ保全運用を習慣化するためのスケジュール設計
これまで解説してきたビットロット対策の各種手法は、いずれも継続的な実行が前提となっています。
ハッシュ値の照合もスクラビングも、一度実行して終わりではなく、定期的に繰り返すことで初めてその効果を発揮します。
しかし、日々の業務や生活の中で、これらの作業を忘れずに継続することは案外難しいものです。
そこで、スケジュール設計と自動化を組み合わせた運用体制の構築が重要となります。
データ保全運用を習慣化する鍵は、作業の粒度を適切に分解し、頻度に応じたスケジュールに落とし込むことです。
全ての作業を毎日行うのは非現実的であり、かといって全てを年に1回にまとめると、作業負荷が集中しすぎて継続不可能になります。
データの重要度と作業の緊急性に応じて、日次、週次、月次、四半期、年次といった階層的なスケジュールを設計することで、無理のない運用が実現できます。
自動化できる作業は積極的に自動化し、人手が必要な作業はカレンダーに固定の予定として登録する習慣をつけるのが効果的です。
また、作業結果の記録を残すことで、過去の健全性トレンドを把握でき、異常の早期発見にも寄与します。
データ保全は、予防医学のようなものです。
日頃の小さな手入れが、将来の大きな損失を防ぐのです。
月次・四半期・年次のチェック項目と運用フロー
データ保全運用の具体的なスケジュール設計例を、以下に示します。
これはあくまで一例であり、保有するデータの量や重要度、使用しているストレージ構成に応じて調整してください。
月次のチェック項目は、比較的軽量で頻度の高い監視作業を中心に構成します。
NASやサーバーの稼働状況確認、エラーログの目視チェック、バックアップの正常終了確認などが該当します。
自動化されている作業であっても、結果の確認は人手で行う必要があります。
月次の作業時間は、全体で30分程度を目安にしてください。
四半期のチェック項目は、より本格的な検証作業を行います。
スクラビングの実行と結果確認、ハッシュ値のサンプリング照合、外付けHDDのリフレッシュ(電源投入とデータ読み出し)、バックアップのリストアテストなどが含まれます。
これらは比較的時間を要する作業であるため、業務の少ない日や休日に実施するのが適切です。
四半期の作業時間は、2時間程度を想定してください。
年次のチェック項目は、運用体制そのものの見直しを行います。
全データのハッシュ値照合、ストレージデバイスの寿命評価と交換計画、バックアップ戦略の見直し、クラウドストレージの契約更新とコスト見直し、ドキュメントの更新などが該当します。
年次作業は、データ保全の総点検の位置づけとなります。
年次の作業時間は、半日から1日程度を確保してください。
以下に、階層的なチェック項目をまとめた表を示します。
| 頻度 | 主なチェック項目 | 想定作業時間 | 自動化の可否 |
|---|---|---|---|
| 月次 | エラーログ確認、バックアップ完了確認、稼働状況監視 | 30分 | ログ監視は自動化可 |
| 四半期 | スクラビング実行、ハッシュ値サンプリング照合、リストアテスト | 2時間 | スクラビングは自動化可 |
| 年次 | 全ハッシュ照合、デバイス寿命評価、戦略見直し、ドキュメント更新 | 半日〜1日 | ハッシュ計算は自動化可 |
運用フローの設計においては、異常検出時の対応手順を事前に定義しておくことも重要です。
例えば、スクラビングでエラーが検出された場合のフローは以下のようになります。
- エラーの詳細をログから確認し、影響範囲を特定する
- 該当ファイルのバックアップからハッシュ値を確認し、破損の有無を断定する
- バックアップが正常であれば、破損ファイルを復元する
- 破損が発生したドライブのSMART情報を確認し、ハードウェアの異常がないか調査する
- 同一ドライブで繰り返しエラーが発生する場合は、交換を検討する
- 事後報告書を作成し、今後の防止策を検討する
このようなフローをドキュメント化しておくことで、異常発生時の対応を迅速かつ適切に行えます。
パニックにならず、定められた手順に従って対処できるという安心感は、運用継続の大きな支えとなります。
最後に、データ保全運用の習慣化において、報酬の仕組みを作ることも有効です。
例えば、四半期のチェックを完了したらカレンダーに印をつける、年次の総点検を終えたら新しいストレージデバイスの購入を検討する、といった形で、作業の完了を可視化し、次へのモチベーションを維持する工夫を取り入れるのも一案です。
データ保全は、一度きりの作業ではなく、継続的な見守りが最も効果的な対策です。
次章では、これまでの内容を総括し、記事のまとめと致します。
データ保全は継続的な見守りこそが最も効果的な対策である
本記事を通じて、HDDにおけるビットロットの仕組みから、具体的な対策、そして長期的な運用設計までを解説してまいりました。
改めて強調したいのは、データ保全において最も重要なのは、一度きりの対策ではなく、継続的な見守りの姿勢であるということです。
ビットロットは静かに、そして着実に進行する現象です。
気づかないうちに大切なデータが損なわれ、気づいたときには手遅れになっているというケースは、決して稀ではありません。
これまで取り上げてきた対策は、それぞれが独立した効果を持ちつつも、最も高い信頼性を得るためには、これらを組み合わせて多層的な防御を構築することが求められます。
個々の手法を振り返ってみましょう。
まず、ビットロットの存在を知り、その発生メカニズムを理解することは、対策の第一歩となります。
知らない脅威に対しては、防ぐことも気づくこともできません。
HDDの磁気記録が時間と環境によって劣化するという物理的な事実を受け入れ、その上で適切な保存環境を整えることは、最も基本的な予防策です。
次に、データスクラビングによる定期的な整合性確認は、ビットロットの早期発見の要となります。
自動化されたスクラビング機能を有効にし、エラーログを監視することで、人間の記憶に依存しない確実な検出体制を構築できます。
RAID構成による冗長性の確保は、単一のドライブ故障に対する耐性を高め、さらにスクラビングと組み合わせることでビットロットの修復能力も得られます。
ただし、RAIDは万能ではなく、バックアップとの併用が不可欠であることを忘れてはなりません。
ハッシュ値チェックは、ファイルレベルでの完全性保証を可能にする強力な手段です。
SHA-256などの堅牢なアルゴリズムを用いて、保存時と照合時のハッシュ値を比較することで、1ビットの変化であっても確実に検出できます。
ハッシュデータベースの体系的な管理と、定期的な照合運用を習慣化することで、長期保存における客観的な健全性評価が可能となります。
外付けHDDやNASでの長期アーカイブにおいては、適切な温度・湿度管理と、NASのスクラビング機能の有効化が、デバイスの寿命とデータの信頼性を左右します。
クラウドストレージとの併用は、ローカル対策ではカバーしきれない物理的な脅威に対する最終防衛ラインです。
3-2-1バックアップルールを実践し、地理的に離れた場所に暗号化されたバックアップを保持することで、万が一の事態にも対応できる柔軟性を確保できます。
ファイルシステムの選択も、データ保全の根幹をなす重要な決定です。
ZFSやBtrfsの自己修復機能を活用できれば、システムレベルでのビットロット対策が実現します。
NTFSやext4を利用する場合は、その限界を理解した上で、ハッシュ値管理などの代替手段で補完することが求められます。
そして最後に、これら全ての対策を継続的に実行するためのスケジュール設計と習慣化が、データ保全の成否を分けます。
月次、四半期、年次の階層的なチェック体制を構築し、自動化と人手による確認を適切に組み合わせることで、無理のない運用が実現します。
以下に、本記事で解説した対策の全体像をまとめます。
| 対策の層 | 具体的な手法 | 主な効果 |
|---|---|---|
| 予防層 | 適切な保管環境、温度・湿度管理 | ビットロット発生リスクの低減 |
| 検出層 | スクラビング、ハッシュ値照合、SMART監視 | データ破損の早期発見 |
| 修復層 | RAID構成、ZFS/Btrfsの自己修復 | 自動的なデータ修復 |
| 冗長層 | ローカルバックアップ、クラウドバックアップ | 複数世代のデータ保持 |
| 運用層 | スケジュール設計、自動化、ドキュメント化 | 継続的な保全の実現 |
データ保全は、完璧なシステムを一度構築すれば終わるものではありません。
ストレージデバイスは経年劣化し、技術は進化し、データの量と重要性も変化していきます。
その変化に応じて、運用体制を見直し、改善を続けることが求められます。
大切なのは、データに対して諦めずに見守り続ける意志です。
デジタルデータは、紙の写真やフィルムとは異なり、物理的な劣化を目で確認しにくい存在です。
その分、意識的に健全性を確認し、適切な対策を講じる責任が、データを管理する私たち一人ひとりにあります。
本記事が、皆様の大切なデータを長期にわたって安全に守るための一助となれば幸いです。
データ保全の道は、継続こそが最良の対策であることを、改めて胸に刻んでいただければと思います。
コメント