大容量データのバックアップにおいて、最も重要視すべきポイントは何でしょうか。
保存容量の大きさや転送速度もさることながら、万が一の障害発生時にデータを確実に守り抜く「耐障害性」こそが、バックアップ用ファイルシステムに求める絶対条件と言えます。
今回は、Windows環境で広く普及しているNTFSと、高いデータ保全性で知られるZFSという2つのファイルシステムに焦点を当てます。
それぞれの仕組みと特徴を比較しながら、大容量データを安全に守り抜くための最適な選択肢を徹底的に検証していきましょう。
なお、両者の耐障害性における基本的なアプローチの違いは以下の通りです。
| ファイルシステム | 主な対象環境 | 耐障害性のアプローチ | データ整合性機能 |
|---|---|---|---|
| NTFS | Windows | ジャーナリングによる復元 | あり(自動修復あり) |
| ZFS | UNIX系・NAS等 | コピーオンライトとチェックサム | あり(高度な自己修復) |
それでは、両者の技術的な詳細を見ていきましょう。
大容量データのバックアップに求められるファイルシステムの要件
デジタルカメラの高画質化や、4K・8K動画の普及、さらに業務システムにおけるログデータの蓄積など、日々生成されるデータ量はかつてない規模で増大しています。
このようなデータ爆炸時代において、大容量データをどのように安全に保管し、いざという時に確実に復元できるかは、個人・法人を問わず極めて重要な課題です。
データ爆炸時代におけるバックアップの重要性
現代のデジタル社会において、データは事実上の資産そのものと言っても過言ではありません。
一度大切なデータを失ってしまうと、取り返しのつかない損害を被る可能性があります。
特に数テラバイトから数ペタバイトに及ぶ大容量データの場合、その消失は単なるデータの破損にとどまらず、システムの長時間停止や信用失墜といった致命的な被害に直結します。
大容量データのバックアップにおいて考慮すべき重要なポイントは以下の通りです。
- 単純なデータの複製だけでなく、継続的な保全性の確保
- ハードウェア障害時の迅速な復旧能力
- 長期間保存時のデータ劣化(ビットロット)への対策
単に別のドライブにデータをコピーするだけでは、真のバックアップとは言えません。
万が一の障害発生時にデータを確実に守り抜くためには、データそのものの整合性を維持する強靭な仕組みが必要不可欠です。
ファイルシステムがデータ保全に与える影響
バックアップの信頼性を左右する最も根本的な要素こそが、ストレージを管理する「ファイルシステム」です。
ファイルシステムは、OSがデータを読み書きするための基盤であり、その設計思想によって耐障害性やデータ保全能力が大きく異なります。
大容量データを扱う場合、ファイルシステムの選択は、システム全体の堅牢性を決定づける最も重要な要件と言えます。
例えば、障害発生時の復元力や、データのサイレント破損を検知・修復する機能の有無は、ファイルシステムのアーキテクチャに直結しています。
大容量になるほど、ビットロットと呼ばれる経年劣化によるデータ破損のリスクも無視できなくなります。
今回は、Windows環境で広く普及しているNTFSと、極めて高いデータ保全性で知られるZFSという2つのファイルシステムに焦点を当て、その仕組みと特徴を比較しながら検証を進めましょう。
Windows環境で標準的なNTFSの基本構造と特徴
Windows環境において、最も広く普及しているファイルシステムが「NTFS(New Technology File System)」です。
1990年代のWindows NTから導入され、長年にわたって継続的な改良が加えられてきた実績のあるファイルシステムであり、現代の大容量ストレージにも対応しています。
最大ファイルサイズやボリュームサイズの制限が実質的に存在しないに等しいため、大容量データのバックアップ先としても広く利用されています。
NTFSの基本構造の主な特徴は以下の通りです。
- Bツリー構造を採用したマスターファイルテーブル(MFT)による高速なファイル検索
- ファイルごとのアクセス権限設定や暗号化機能の標準搭載
- ファイルの圧縮やスパースファイルのサポート
これらの高度な機能を標準で備えつつ、Windows OSと完全に統合されている点が、NTFSの最大の強みと言えるでしょう。
NTFSのジャーナリング機能による耐障害性
NTFSが高い耐障害性を誇る最も大きな理由は、ジャーナリング機能を実装している点にあります。
ジャーナリングとは、ファイルシステムへの変更内容を実際のデータ領域に反映する前に、専用のログ領域に記録する仕組みです。
これにより、システムクラッシュや突然の電源断が発生した場合でも、ファイルシステムの整合性を迅速かつ確実に回復できます。
例えば、大容量データの書き込み中に障害が発生した場合でも、ジャーナルログを参照することで未完了のトランザクションを特定し、ロールバック(取り消し)またはロールフォワード(再実行)を適切に行えます。
これにより、ファイルシステム全体が破損する致命的な事態を未然に防ぐことが可能です。
ただし、このジャーナリング機能はあくまで「ファイルシステムのメタデータ」を保護する対象であり、保存したファイルのデータ本体の破損までは検知・修復できない点に留意が必要です。
NTFSを利用する際の注意点と制約
高い汎用性と安定性を誇るNTFSですが、大容量データのバックアップ用途で利用する際にはいくつかの注意点と制約を把握しておく必要があります。
第一に、前述の通りメタデータの保護は徹底されているものの、データ本体のサイレント破損(ビットロット)に対する自己修復機能が弱い点が挙げられます。
長期間保存されたバックアップデータが知らぬ間に崩壊しているリスクを考慮し、別途チェックサムを用いたデータ検証ツールを導入するなどの運用が必要です。
第二に、Windows以外のOS環境との相互運用性の問題です。
| 環境 | NTFSの読み書きサポート状況 |
|---|---|
| Windows | 完全サポート(ネイティブ) |
| macOS | 読み込みのみ(書き込みには別途ソフトが必要) |
| Linux | 標準でサポート可能だが、互換レイヤーを経由することが多い |
マルチプラットフォーム環境でバックアップストレージを共有したい場合、NTFSの仕様上の制約が障壁となり、パフォーマンスの低下や運用上の煩雑さを招くことがあります。
さらに、経年劣化したセクタの処理についても考慮が必要です。
現代の大容量HDDは物理的不良セクタの発生をOSに隠蔽する仕組みを持っていますが、NTFS単体では不良セクタに起因するデータ破損を完全に防ぐことは困難です。
これらの制約を踏まえた上で、適切な運用設計を行うことが重要となります。
次世代ファイルシステムZFSのアーキテクチャと特徴
ファイルシステムの進化において、間違いなく特筆すべき存在が「ZFS(Zettabyte File System)」です。
元々はSun Microsystemsによって開発されたこのファイルシステムは、従来のファイルシステムとボリュームマネージャーを統合した革新的なアーキテクチャを採用しています。
その名の通り、ゼタバイト(1兆ギガバイト)という天文学的なスケールのデータ管理を念頭に設計されており、大容量データのバックアップにおいて真価を発揮します。
ZFSの設計思想における最大の特徴は、ストレージプールという概念の導入です。
複数の物理ドライブを仮想的に1つの大きなプールとして統合し、そこから論理的なボリュームを切り出す仕組みにより、従来のRAIDコントローラーに依存しない高度なデータ管理を実現しています。
ZFSのアーキテクチャにおける主な特徴は以下の通りです。
- ファイルシステムとボリュームマネージャーの完全な統合によるシンプルな管理
- データとメタデータの二重化を前提とした堅牢な設計
- ソフトウェアRAID機能のネイティブサポート
これらにより、ハードウェアの制約に縛られることなく、論理的なレイヤでデータを保護できるのがZFSの最大の強みです。
ZFSのコピーオンライトによるデータ保護
ZFSの卓越したデータ保全性を支える核心技术の一つが、コピーオンライト(Copy-on-Write)です。
従来のファイルシステムでは、データを更新する際に元のデータブロックを直接上書きします。
そのため、書き込み中に障害が発生すると、古いデータも新しいデータも失われる危険性を伴います。
一方、ZFSではデータを上書きせず、常に空き領域に新しいデータを書き込みます。
そして、新しいデータの書き込みが完了した後に、メタデータのポインタを切り替えることで更新を確定させます。
この設計により、書き込み中に障害が発生した場合でも、システムは常に古い有効なデータへのポインタを維持できます。
つまり、システムクラッシュや電源断が起きても、ファイルシステムが破損する可能性が理論上排除されており、常に一貫性のある状態を保ち続けることができるのです。
ZFSの自己修復機能と高い耐障害性
コピーオンライトと並んでZFSの代名詞とも言えるのが、強力な自己修復機能です。
ハードディスクは経年劣化や微弱な磁気変化により、データが知らぬ間に破損するサイレントデータ腐敗(ビットロット)という現象を引き起こします。
大容量データの長期バックアップにおいて、これは非常に厄介な問題です。
ZFSは、データとメタデータのすべてにチェックサムを付与することでこの問題に対処します。
データを読み込む際、常にチェックサムを検証し、もし不一致が検出された場合は、ミラーやRAID-Z(ZFS独自のRAID構成)から正常なデータブロックを自動的に読み出し、破損したブロックを修復します。
この一連のプロセスはシステム稼働中にバックグラウンドで透過的に実行されるため、ユーザーが意識することなくデータの完全性を維持し続けられます。
ZFSの代表的なデータ保護機能による耐障害性の違いをまとめました。
| 機能名 | 従来のファイルシステム(NTFS等) | ZFSのアプローチ |
|---|---|---|
| データ破損の検知 | ツールによる事後チェックが必要 | 読み込み時に常時チェックサムを検証 |
| 破損データの修復 | 別途バックアップからリストア | 正常な冗長データから自動修復 |
大容量データを長期にわたり安全に保持し、万が一の障害時にも確実にデータを守り抜くという要件において、ZFSの自己修復機能は極めて強力な武器となります。
NTFSとZFSの耐障害性を徹底比較
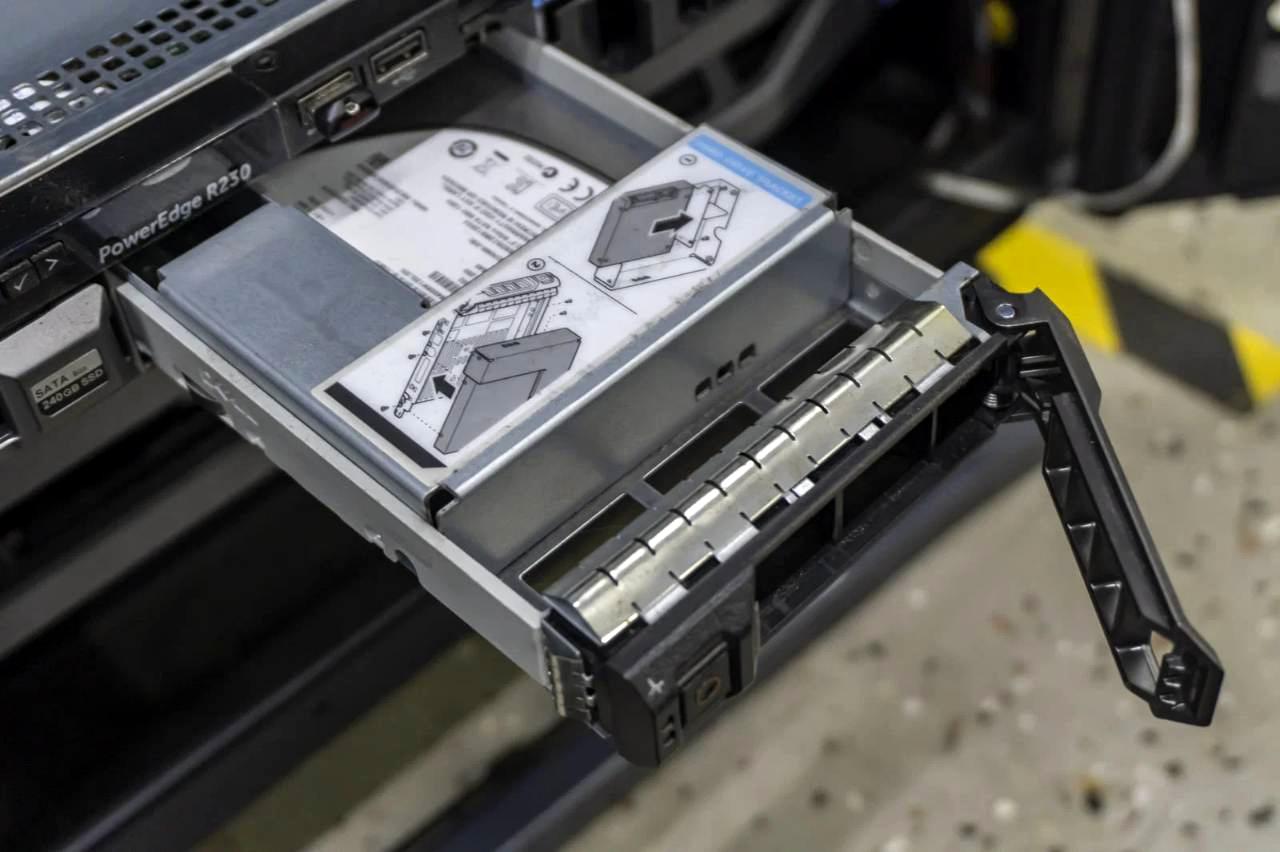
ここまで、Windows環境で広く利用されているNTFSと、次世代アーキテクチャを採用するZFSそれぞれの特徴を見てきました。
大容量データのバックアップというミッションクリティカルな用途において、どちらのファイルシステムが真に信頼に足るのか。
ここからは、両者の耐障害性に焦点を当て、より実運用に即した視点で徹底的に比較検証していきましょう。
ファイルシステムの堅牢性は、単なる仕様書上のスペックだけで決まるものではありません。
実際のハードウェア障害や、長期間の運用に伴うデータ劣化に対して、どれほど実効性のある防御壁を構築できるかが重要です。
データ冗長性と破損検知能力の違い
NTFSとZFSにおける最大の決定的な差異は、データの冗長性確保と、サイレントデータ破損の検知能力にあります。
バックアップデータを長期間安全に保管する上で、我々が最も恐れるべき事態は「データが知らぬ間に壊れていること」です。
ハードディスクは経年劣化により、エラーを返すことなく静かにビット反転を起こすことがあります。
これがビットロットと呼ばれる現象です。
両者のアプローチの違いを整理してみましょう。
- NTFSのアプローチ:ジャーナリングによるファイルシステムのメタデータ保護。データ本体の破損検知は行わず、別途RAIDカード等のハードウェア機能に依存する
- ZFSのアプローチ:すべてのデータブロックにチェックサムを付与し、読み込み時に検証。破損を検知した場合は、冗長構成から自動的に正常なデータを復元する
この設計思想の差は、データの読み込み時の挙動に如実に現れます。
NTFSはRAIDコントローラと連携して一時的なハードウェア障害を吸収することはできても、ストレージから返された破損データを正常なものと誤認するリスクを抱えています。
一方、ZFSはファイルシステム自身がデータの完全性を担保します。
たとえストレージが破損したデータを返してきたとしても、チェックサム検証で即座に異常を検知し、ミラーやRAID-Zから正常なデータを取り出して修復します。
両者の耐障害性の違いを端的に表す比較表をご覧ください。
| 項目 | NTFS | ZFS |
|---|---|---|
| メタデータの保護 | ジャーナリング機能 | コピーオンライト機能 |
| データ本体の破損検知 | 非対応(別途ツールが必要) | 対応(チェックサム検証) |
| 破損データの自己修復 | 非対応 | 対応(冗長データから自動修復) |
大容量データのバックアップという文脈において、この自己修復能力の有無は極めて重要です。
何テラバイト、何ペタバイトというデータを対象に定期的なスクラビング(データの全件スキャンと整合性チェック)を行った際、NTFSでは論理的な破損を見逃す可能性がゼロではありません。
対してZFSは、システム稼働中も含めて常にデータを監視し、静かに破損を修復し続けます。
データの完全性を保つという根本的な要件において、ZFSがNTFSを凌駕していることは明らかでしょう。
次に、これらのファイルシステムを実際のバックアップ環境に導入する際の最適な運用方法について考察します。
大容量データに最適なバックアップ運用とNAS構築の最適解
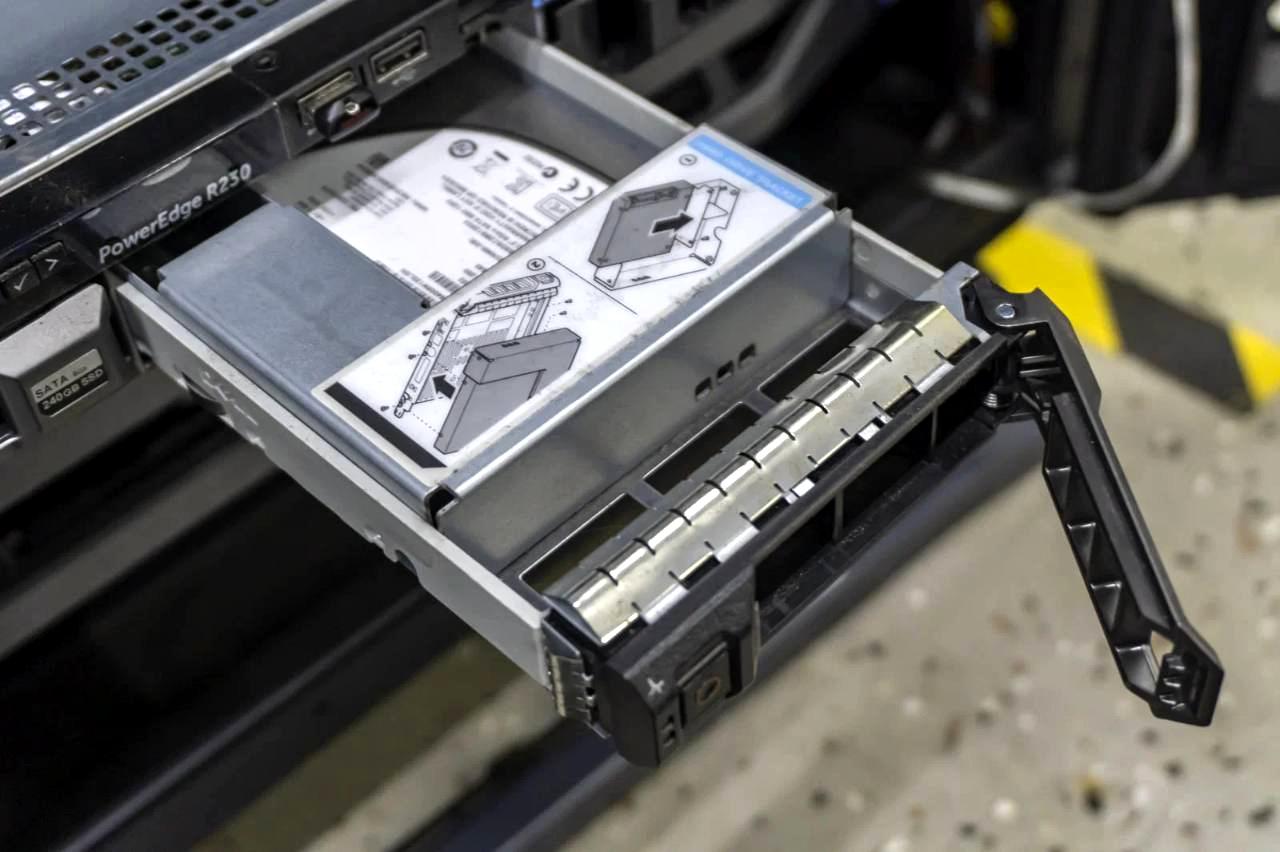
ファイルシステムの理論上の優劣を理解することは重要ですが、それを実際の運用環境にどう適用するかが、システムの真価を問われる局面となります。
大容量データを安全かつ効率的に保護するためには、ファイルシステムの特性を深く理解し、適切なハードウェアアーキテクチャと組み合わせる必要があります。
ここでは、実際のNAS(Network Attached Storage)構築を念頭に置き、最適なバックアップ運用のあり方を考察します。
RAID構成との親和性とストレージ最適化
大容量データのバックアップにおいて、ストレージの冗長化は必須の要件です。
ここで重要となるのが、ファイルシステムとRAID構成の親和性です。
NTFSを利用する場合、一般的にはハードウェアRAIDコントローラ、またはOS標準のソフトウェアRAID機能と組み合わせて運用します。
これらはストライピングやミラーリングといった物理的な冗長性を提供しますが、前述の通りビットロットに対する根本的な防御壁にはなりません。
一方、ZFSはファイルシステム自身がRAID機能を内包しています。
ZFSの提供するRAID-Zは、従来のRAID 5/6の弱点であった「書き込み時の破損(RAID write hole)」をコピーオンライト方式により解消しています。
両者のRAID連携における最適化のアプローチを比較してみましょう。
| 項目 | NTFS + ハードウェアRAID | ZFS (RAID-Z) |
|---|---|---|
| 冗長性の管理 | 専用コントローラに依存 | ファイルシステムが統合管理 |
| データ破損時の修復 | 手動リビルドが必要 | 読み込み時に自動修復 |
| ストレージ最適化 | 固定的なRAID構成 | 柔軟なプール管理とスナップショット |
ZFSを用いたNAS構築では、ストレージプールに複数のディスクを追加するだけで容量を動的に拡張でき、ファイルシステムレベルでスナップショットを取得できます。
この高い柔軟性とデータ保護能力の統合こそが、大容量バックアップに最適なストレージを構築する鍵となります。
Windows環境とUNIX系環境の運用上の考慮点
ファイルシステムの選定は、単体の性能だけでなく、既存のITインフラとの親和性も考慮しなければなりません。
ここで最大の障壁となるのが、OS間の運用上の考慮点です。
NTFSはWindows環境と完全に統合されているため、Windowsサーバーを中心としたインフラにおいては、何の追加ソフトウェアもなしにそのままマウントして読み書きが可能です。
ただし、LinuxベースのNASを構築する場合、NTFSはカーネルモジュールであるntfs-3gを経由するため、CPU負荷の増加やパフォーマンスの低下が懸念されます。
対照的に、ZFSはネイティブでUNIX系環境(Linux、FreeBSDなど)で動作します。
OpenZFSプロジェクトの尽力により、現在では非常に安定して運用できるまでに成熟しています。
ただし、ZFSを運用する上では、ハードウェアリソースに対する考慮が必要不可欠です。
- メモリ要件:ARC(Adaptive Replacement Cache)と呼ばれるメモリキャッシュを最大限に活用するため、大容量のメモリが推奨されます
- CPU負荷:チェックサム計算やデータの圧縮・重複排除処理が行われるため、ある程度のCPU演算能力が求められます
- Windowsからのアクセス:Samba(SMB)プロトコルを経由してネットワーク越しにデータをやり取りするため、ファイルサーバーとしては全く問題ありません
つまり、Windowsクライアントから利用する場合でも、バックアップ用のストレージサーバー側をUNIX系OS+ZFSで構築し、ネットワーク経由でアクセスするアーキテクチャが、耐障害性と運用効率の双方において最適解と言えるでしょう。
大容量バックアップの障害発生時の復旧手順と検証
どれほど堅牢なファイルシステムを採用し、万全のバックアップ体制を構築したとしても、ハードウェアの物理的な故障を完全に排除することは不可能です。
大容量データのバックアップ運用において真に求められるのは、「障害が発生しないこと」よりも「障害発生時にいかに迅速かつ確実にデータを復旧できるか」という点にあります。
ここでは、実際のディスク障害を想定したシミュレーションを通じて、NTFSとZFSそれぞれの復旧プロセスを検証します。
システム管理者にとって、障害対応の時間はまさに臨戦態勢です。
平時にあったる復旧手順の明確化と、その実効性の検証こそが、システムの停止時間を最小限に抑える生命線となります。
ディスク障害時のデータ復旧シミュレーション
それでは、具体的な障害シナリオを設定して検証を始めましょう。
ここでは、RAID構成のストレージプールを構築している状態で、構成ディスクの1台が物理的に故障し、アクセス不能に陥ったケースを想定します。
この障害発生時、NTFSとZFSそれぞれのファイルシステムがどのような挙動を示すのか。
その復旧フローを比較してみましょう。
| 復旧フェーズ | NTFS + ハードウェアRAIDの挙動 | ZFS (RAID-Z)の挙動 |
|---|---|---|
| 障害の検知 | RAIDコントローラが検知しアラートを通知 | ZFSが検知しストレージプールを縮退状態に移行 |
| データの整合性 | リビルド中に別のディスクで読み取りエラー発生時、データ欠損のリスクあり | チェックサムにより正常なデータを特定し、欠損リスクを最小化 |
| 復旧後の検証 | 別途ファイル整合性チェックツール等での手動検証が必要 | スクラビングを実行し、ファイルシステムレベルで自己修復 |
NTFS環境においてディスクが故障した場合、ハードウェアRAIDコントローラの機能に依存してホットスペアへのリビルドが開始されます。
しかし、大容量ディスクのリビルドには多大な時間を要し、その間に別のディスクに負荷が集中して新たなエラーを引き起こす連鎖的な障害のリスクを抱えます。
また、RAIDのパリティ計算とNTFSのジャーナリングは独立しているため、リビルド完了後にデータが本当に正常であるかは、別途ファイルレベルでの検証が必要です。
一方、ZFS環境での復旧プロセスはよりシームレスかつ論理的です。
ディスク故障時、ZFSは即座に対象のvdev(仮想デバイス)を縮退状態とし、ホットスペアへの置き換えを行います。
この際、ZFSのリビルドは従来のRAIDのように全セクタを単純にコピーするのではなく、ファイルシステムの構造に基づいて生きているデータのみを再構築します。
これにより、大容量ボリュームであってもリビルド時間を大幅に短縮できる可能性があります。
復旧後にはZFSの強力な機能である「スクラビング(Scrub)」を実行します。
これにより、全データブロックのチェックサムを検証し、必要であれば冗長データから破損箇所を自己修復します。
ディスク障害時の復旧において特に注目すべきは、以下の点です。
- 復旧中のデータ保護:NTFSは復旧プロセス中のデータ完全性を担保できないが、ZFSはリビルド中もチェックサムによりデータを保護し続ける
- 復旧後の確実性:NTFSはOSやアプリケーションレベルでの検証が必要だが、ZFSはファイルシステムレベルで完全性を保証する
大容量データの復旧において、ディスクの交換自体は物理的な作業に過ぎません。
重要なのは、その後のデータ整合性をどのように保証するかです。
ZFSの自己修復アーキテクチャは、障害発生時の心理的負担と運用リスクを劇的に低減させる強力な武器となります。
バックアップ戦略におけるコストとパフォーマンス
ファイルシステムの耐障害性や復旧手順を検証していくと、必然的に直面するのが「コスト」と「パフォーマンス」のトレードオフという根源的な課題です。
大容量データを守るためには、高度な技術を支えるハードウェアリソースが必要不可欠です。
しかし、企業や個人が利用できる予算は有限であり、無限のリソースを投入できるわけではありません。
極めて堅牢なファイルシステムを採用した結果、システム全体の構築コストが膨張し、運用パフォーマンスが著しく低下してしまうようでは本末転倒です。
バックアップ戦略の最適化においては、単に最新の技術を導入するだけでは不十分と言えます。
導入規模や予算、求められる復元速度を総合的に評価し、最もバランスの取れたアプローチを選択することが求められます。
NTFSとZFSそれぞれを採用した場合のコストおよびパフォーマンスの傾向を比較してみましょう。
| 項目 | NTFS運用の特徴 | ZFS運用の特徴 |
|---|---|---|
| ハードウェア要件 | 標準的なPC構成で軽量に動作 | 大容量メモリと高性能なCPUを要求 |
| ストレージ効率 | 圧縮機能はあるが制約が多い | 透過的圧縮と重複排除による高い効率化 |
| 予算あたりの容量 | ハードウェアRAID構成で容量を確保しやすい | チェックサムやRAID-Zのオーバーヘッドで効率が下がる |
ZFSはその高度なデータ保護機能ゆえに、 ARC(Adaptive Replacement Cache)と呼ばれる巨大なメモリキャッシュを消費します。
また、書き込み時のチェックサム計算やコピーオンライトによるデータ断片化の抑制処理など、常にCPUリソースを要求するアーキテクチャとなっています。
そのため、ZFSを用いたバックアップサーバーを構築する際には、ECCメモリの搭載やマルチコアCPUの採用が推奨され、イニシャルコストが上昇する傾向にあります。
一方で、パフォーマンスの観点から見ると評価が変わってきます。
ZFSはメモリを大量に消費する代わりに、そのキャッシュを活用して読み込み速度を劇的に向上させます。
また、透過的なデータ圧縮や重複排除機能を備えているため、大容量データを効率的に格納でき、結果としてストレージの拡張タイミングを先送りできるコストメリットも生み出します。
バックアップ戦略を立案する上で考慮すべき具体的なポイントは以下の通りです。
- イニシャルコストとランニングコストのバランス:ハードウェアの初期投資を優先するか、拡張性による将来的なコスト削減を見込むか
- データアクセスの頻度:常時アクセスされるホットデータか、長期保存のコールドデータかで最適なストレージ構成が変わる
- パフォーマンスへの許容度:バックアップの取得時間やリストア時の速度が業務に与える影響を定量化する
小規模なオフィスや個人のバックアップ環境であれば、標準的なハードウェア構成で安価に構築できるNTFS+ハードウェアRAIDの組み合わせが、十分に合理的な選択肢と言えるでしょう。
パフォーマンスの低下を招くことなく、既存のWindowsインフラにシームレスに統合できます。
しかし、数ペタバイトクラスの大容量データを扱うエンタープライズ環境や、データ消失が直接的なビジネス被害に直結するミッションクリティカルな領域においては、ZFSの要求するハードウェアコストは、データ資産を守るための必要経費として割り切れるものです。
高度な自己修復機能とストレージ最適化により、長期的な運用コストとリスクを低減させる投資と捉えるべきです。
つまり、バックアップ戦略におけるコストとパフォーマンスの最適解は、組織のデータに対するリスク許容度と予算規模によって明確に変わります。
技術的な優劣だけでなく、TCO(総所有コスト)の観点から、理性的かつ現実的な判断を下すことこそが、システム設計者の真骨頂と言えるのではないでしょうか。
導入規模に応じたファイルシステムの選択基準
ファイルシステムの技術的な優劣をいくら深く掘り下げても、それを実行するインフラの規模や目的に合致していなければ、最適なソリューションとは言えません。
大容量データのバックアップ基盤を設計する際、最も重要なのは「導入規模」と「運用体制」に適合した技術を選定することです。
小規模なオフィスから大規模なエンタープライズのデータセンターまで、求められる要件は根本的に異なります。
ここでは、スケールに応じたファイルシステムの選択基準を整理してみましょう。
まず、個人や小規模オフィスでのバックアップ構成を想定します。
データ容量が数十テラバイト程度であり、専任のシステム管理者がいない環境では、導入の容易さと保守のシンプルさが何より優先されます。
この領域では、Windows環境に完全に統合されたNTFSが非常に合理的な選択肢です。
NTFSで構築されたNASや外付けストレージは、特別な知識がなくても直感的にセットアップが可能です。
ハードウェアRAIDを有効にすれば、ある程度のディスク障害には耐えられます。
もちろんビットロット等のサイレントデータ破損への根本的な対策は講じられませんが、定期的にバックアップデータの整合性をチェックするツールを併用し、重要なデータはクラウドストレージ等に逃がす運用を徹底すれば、コストパフォーマンスの高い安全なバックアップ体制を構築できます。
次に、中規模から大規模な企業向けのバックアップ環境はどうでしょうか。
データ量が数百テラバイトからペタバイトクラスに達すると、単なるディスクの冗長化だけではデータを守り切れなくなります。
長期間アーカイブされたデータの劣化リスクや、膨大なデータをスキャンする際のパフォーマンス低下が致命的な問題になるためです。
この規模においては、ZFSの採用が極めて有効な手段となります。
スナップショット機能による高頻度なバックアップや、スクラビングによる自己修復メカニズムは、データ資産を長期間にわたり完全な状態で維持するための強力な武器となります。
規模別のファイルシステム選択における基本方針をまとめました。
| 導入規模 | 推奨ファイルシステム | 重視すべき要件 | 運用上のアプローチ |
|---|---|---|---|
| 個人・小規模 | NTFS | 導入容易性・低コスト | 外付けHDDや簡易NASでの運用 |
| 中規模 | ZFS | データ保全性・拡張性 | NASアプライアンスやサーバー構築 |
| 大規模・エンタープライズ | ZFS | 無停止性・自己修復機能 | クラスタ構成やストレージプールの集約 |
選択基準においてもう一つ見逃してはならないのが、バックアップの階層化という考え方です。
全てのデータを単一のファイルシステムで賄う必要はありません。
例えば、頻繁にアクセスされ更新されるホットデータはNTFSベースの高速なストレージに配置し、変更頻度の低い大容量のアーカイブデータはZFSベースのストレージに配置して徹底的な保護を図る、といったハイブリッドな運用も非常に理にかなっています。
この階層化を実現するためには、以下のポイントを押さえておく必要があります。
- データのライフサイクル定義:データが生成されてから廃棄されるまでの期間と、各フェーズでのアクセス頻度を明確にする
- リスク許容度の評価:データが消失した際のビジネスインパクトを定量化し、保護に投資すべき優先順位を決定する
- 運用リソースの把握:システムの管理に割ける人的リソースと予算を正確に把握し、複雑な運用が持続可能かを判断する
テクノロジーの進化は目覚ましく、かつてはエンタープライズ限定だった機能が中小企業でも手の届く範囲になりつつあります。
しかし、機能の豊富さに惹かれて不必要な複雑性を導入してしまうと、保守コストの増大やトラブル時の切り分け困難といった新たなリスクを招きかねません。
ファイルシステムの選択は、単なる技術選定の枠を超え、組織のデータガバナンスそのものを左右する重要な意思決定です。
自社の導入規模と運用リソースを冷静に見極め、最も持続可能なバックアップアーキテクチャを構築することが、システム設計者に課せられた最も重要な責務と言えるでしょう。
まとめ:大容量データを守るための最適なファイルシステム選び
本記事では、大容量データのバックアップに最適なファイルシステムを見極めるため、Windows環境で広く普及しているNTFSと、極めて高い耐障害性を誇るZFSのアーキテクチャから運用面までを徹底的に検証してきました。
デジタルデータの爆発的な増大が続く現代において、バックアップの役割は単なるデータの複製から、事業継続性を担保するための戦略的インフラへと昇華しています。
その中でファイルシステムの選定は、データの寿命と復元可能性を直接左右する極めて重要な意思決定です。
検証を通じて見えてきた両者の特性を改めて整理してみましょう。
| 比較項目 | NTFSの評価 | ZFSの評価 |
|---|---|---|
| 耐障害性 | ジャーナリングによるメタデータ保護で一定の安全性を確保 | コピーオンライトとチェックサムによりデータ完全性を完全保証 |
| 自己修復機能 | 非対応(別途検証ツール等での手動運用が必要) | 対応(破損検知から自動修復までを自律的に実行) |
| 導入の容易さ | Windows環境と完全に統合されており極めて高い | UNIX系知識とハードウェアリソースを要求される |
NTFSの最大の強みは、その圧倒的な汎用性と手軽さにあります。
Windows環境との親和性は群を抜いており、特別な知識を要さずに大容量ストレージを構築可能です。
しかし、データ本体のサイレント破損に対する根本的な防御機能を持たないという弱点は、長期的なバックアップ保存において無視できないリスクとなります。
ハードウェアRAIDと併用することで物理障害には耐えられますが、ビットロットによるデータの崩壊までは防げません。
一方、ZFSはアーキテクチャの根底からデータ保全性を追求したファイルシステムです。
すべてのデータブロックに付与されたチェックサムとコピーオンライトの仕組みにより、システムクラッシュやビットロットからデータを完全に保護します。
障害発生時にも、冗長データから破損箇所を自動的に修復する自己修復機能により、管理者の負担を最小限に抑えつつデータを守り抜きます。
ただし、その強力な機能を支えるためには大容量のメモリや高性能なCPUなど、相応のハードウェアリソースと専門的な運用知識が求められます。
最適なファイルシステムを選ぶための判断基準は、以下の3点に集約されます。
- データ資産の重要度:消失した場合のビジネスインパクトの大きさ
- ストレージの規模と長期保存の要件:数テラバイトの運用か、ペタバイト級の長期アーカイブか
- 投資可能な予算と運用リソース:イニシャルコントと管理工数をどこまで許容できるか
小規模なオフィスや個人の環境であれば、手軽に導入できてWindowsとシームレスに連携できるNTFSを選択するのが最も現実的かつ合理的な判断です。
重要なデータはクラウドストレージなどの別メディアに逃がす運用を徹底すれば、十分に安全なバックアップ体制を構築できます。
しかし、ビジネスの基幹を支える数百テラバイト以上の大容量データを長期間保管し、万が一の障害時にも一言のデータ欠損も許されないミッションクリティカルな環境においては、ZFSの導入が必須と言えます。
初期投資や学習コストは嵩むものの、ZFSがもたらす自己修復機能と絶対的なデータ保護能力は、投資に見合うだけの揺るぎない価値を提供してくれるはずです。
大容量データを守るための最適なファイルシステム選びに銀の弾丸はありません。
組織の持つデータの性質、予算、そして運用体制を冷静に見極め、最も持続可能で堅牢なバックアップアーキテクチャを構築することが、デジタル資産を未来へと繋ぐための最重要課題です。
本記事の検証が、皆様のシステム設計における理性的な意思決定の一助となれば幸いです。
コメント