長期間にわたり稼働させ続けるRAID 5アレイ。
導入当初は快適な速度と冗長性を誇るものの、気づけばディスクの稼働時間は数万時間を超え、メーカー保証の壁も目前です。
そんな時、ふと頭をよぎるのが「HDDの寿命はあとどれくらいか」「交換のサインはいつ掴むべきか」という疑問ではないでしょうか。
結論から言えば、RAID 5におけるHDDの交換タイミングは「SMART情報の異常」と「定期的な自己監視レポート」の2つが主力指標となります。
具体的には、以下のような兆候が見られたら、即座に対応を検討すべきです。
- 再割り当てセクタ数(Reallocated Sectors)の急増
- 回転数やシークエラー率の著しい悪化
- 不定期なタイムアウトやコマンド完了遅延の発生
ただし、ここで忘れてはならないのが、RAID 5は「1台の障害」までしか許容しないという脆い構造です。
つまり、2台目が同時に落ちれば、アレイ全体がクラッシュし、データは完全に消失します。
実際、長期運用ディスクでは、リビルド中の高負荷が引き金となり、残った古いディスクが連鎖故障を起こすケースが後を絶ちません。
では、具体的な交換周期の目安はあるのでしょうか。
一般的な企業向けの運用ノウハウでは、稼働時間ベースで3〜5年、または書き込み量で200TB〜300TBがひとつの境界線とされます。
しかし、これはあくまで平均値であり、使用環境の温度や振動、電源品質によって大きく変動します。
だからこそ、カレンダーではなく、数値データに基づいた計画交換がプロの流儀です。
| 運用年数 | SMART警告率 | 推奨アクション |
|---|---|---|
| 0〜2年 | 低(5%未満) | 通常監視を継続 |
| 2〜4年 | 中(5〜15%) | 予備ディスクを準備 |
| 4〜5年 | 高(15%超) | 計画的に交換を実施 |
| 5年以上 | 極高 | 即時交換を推奨 |
そして、ここが最も重要なポイントです。
RAIDはバックアップの代替にはなりません。
たとえRAID 5で冗長性を確保していても、人的ミスによるファイル削除、ファームウェアバグ、電源サージ、さらにはランサムウェアといった論理的障害には無力です。
つまり、「RAID+バックアップ」が二重化の鉄則であり、片方だけでは「ほぼ裸」と同じリスクを負っていると認識すべきでしょう。
では、どう実践するか。
私が推奨するのは、3-2-1ルールに準拠したバックアップ戦略です。
すなわち、データのコピーを3つ持ち、2種類以上のメディアに保存し、1つはオフサイトに置く。
これにより、HDDの物理故障だけでなく、火災や盗難といった局所的な災害にも耐性が生まれます。
バックアップの頻度については、更新頻度の高いデータは毎日または数時間ごとの増分バックアップ、システムイメージは週次で取得するのが現実的です。
そして、重要なのは定期的なリストアテストです。
バックアップが正しく取れていても、復元できなければ意味がありません。
少なくとも四半期に一度は、テスト用の別マシンや仮想環境で復元手順を確認する習慣をつけてください。
最後に、HDDの交換作業自体にも落とし穴があります。
ホットスワップ対応であっても、事前にコントローラのファームウェアを最新化し、交換前後のSMARTログを必ず保存することをお勧めします。
また、交換後に即座にフルリビルドを開始するのではなく、まずはパリティチェックを実行し、アレイの整合性を確認してからリビルドに移る――この一手間が、二次障害を防ぐ秘訣です。
長く使えば使うほど、HDDは静かに疲弊していきます。
それでも、適切な監視と計画、そして何より「バックアップあってのRAID」という原則を忘れなければ、あなたのデータはきっと守られるでしょう。
次にディスクのアクセスランプが怪しく点滅したら、それは単なる動作ではなく、あなたへの「メッセージ」だと考えてみてください。
RAID 5でHDDを長期運用する前に知っておべき「冗長性」の現実
RAID 5を導入する際、多くの方が「1台のHDDが壊れてもデータは大丈夫」という安心感に魅了されます。
確かに、パリティ情報を分散配置することで、単一ドライブの故障に対して冗長性を提供するのがRAID 5の役割です。
しかし、この「冗長性」という言葉には、思いのほか多くの制約と落とし穴が潜んでいるのもまた事実です。
長期運用を視野に入れるなら、まずこの現実を正確に理解しておく必要があります。
RAID 5の基本的な仕組みを簡単におさらいしましょう。
3台以上のHDDで構成され、データはブロック単位で分割され、その中の1台分に相当するパリティ情報が全ドライブに分散して書き込まれます。
このパリティがあれば、仮に1台が故障しても、残りのドライブから元のデータを数学的に復元できる――これが冗長性の根幹です。
ただし、ここで強調しておきたいのは、RAID 5が守れるのは「物理的なドライブの単一障害」だけだという点です。
では、長期運用において、この冗長性はどのように脆くなるのでしょうか。
まず挙げられるのが、経年劣化によるHDDの性能ばらつきです。
導入当初は同じロット、同じファームウェアのディスクであっても、数年の運用でそれぞれの摩耗度合いは大きく異なります。
あるディスクはセクタエラーが増え、別のディスクは応答速度が低下し、また別のディスクは温度履歴の影響で内部抵抗が変わってくる。
こうした個体差が大きくなると、リビルド時にパリティ計算の整合性が取りづらくなり、結果としてエラー率が上昇するのです。
次に見過ごせないのが、RAIDコントローラやソフトウェアRAIDの実装依存性です。
エントリークラスのコントローラでは、エラー訂正やタイムアウト処理のロジックが簡略化されており、長期運用で発生する微妙なタイミングズレやコマンドリトライに弱いケースがあります。
また、ソフトウェアRAIDの場合、OSやドライバのアップデートによって動作が変わり、それまで安定していたアレイが突然不安定になることも稀ではありません。
さらに、物理的な環境要因も無視できません。
電源のリップルノイズ、ケース内の振動、冷却ファンの風圧変化――これらはすべてHDDのメカニカル部品にストレスを与え続けます。
特に、連続稼働時間が3万時間を超える頃から、ベアリングの摩耗やヘッドの追従精度低下が顕在化し始めます。
これらはSMART情報に数値として現れる前に、微妙なデータ読み取り誤差として積み重なるため、気づいた時にはパリティの再計算が正しく行われていない状態に陥っている可能性があります。
そして、最も多くの管理者が直面するのが「サイレントデータ破損(サイレントコラプション)」です。
これは、HDD自体がエラーを報告せずに、誤ったデータを正常なものとして返してしまう現象です。
RAID 5はパリティによる冗長性を持ちますが、このパリティ自体がサイレントコラプションの影響を受けると、リビルド時に破損したパリティを使って復元処理を行い、結果として正常だったはずのデータまで壊してしまうという逆説的な事態が発生します。
これを防ぐには、データチェックサム機能を備えたファイルシステム(ZFSやBtrfsなど)と組み合わせる必要がありますが、多くの一般的なNASやRAIDカードはそこまで考慮していません。
ここで整理のため、RAID 5の冗長性が「有効に機能する前提条件」を列挙してみましょう。
- 故障するのは同時に1台までであり、リビルド中に別のドライブがエラーを起こさないこと
- すべてのドライブのファームウェアと回転速度が実質的に同一水準であること
- コントローラのエラーリカバリ機能が標準的かつ堅牢であること
- 定期的なパリティチェックやスクラビングが運用スケジュールに組み込まれていること
- データ破損がドライブ障害として正しく報告されること(サイレントコラプションが発生していないこと)
これらの条件が一つでも欠けると、RAID 5の冗長性は「あってないような」状態になります。
特に驚くべきは、あるストレージベンダの障害レポートによれば、5年以上稼働したRAID 5アレイのリビルド試行時に、約40%のケースで2台目のエラーが確認されるというデータです。
つまり、長期運用において「1台の故障」は「複数台故障の引き金」に過ぎないケースが少なくないのです。
とはいえ、RAID 5自体が無価値なわけでは決してありません。
適切な監視と計画があれば、コストパフォーマンスに優れた冗長構成として十分に機能します。
重要なのは、この冗長性を「絶対的な安全装置」ではなく、「確率的なリスク低減策」として捉える視点です。
HDDは消耗品であり、その消耗速度は均一ではありません。
そして、長期運用における真の敵は、単一の故障そのものではなく、経年変化による「状態のばらつき」であると認識すべきでしょう。
したがって、RAID 5を構築する際には、最初から「いつか必ず交換時期が来る」ことを前提に設計する必要があります。
そしてその前提に立った時、初めて「冗長性の現実」と向き合う覚悟ができるのです。
次の章では、その現実を数値として捉えるためのSMART情報とエラーログの読み解き方について、具体的に掘り下げていきます。
HDD寿命のサイン:SMART情報とエラーログの読み解き方
RAID 5の長期運用において、最も頼りになるのがHDD自身が発する「声」です。
その声とは、SMART(Self-Monitoring, Analysis and Reporting Technology)情報と、OSやコントローラが記録するエラーログに他なりません。
これらを正しく読み解くことができれば、物理的な故障の数週間から数ヶ月前に兆候を察知し、計画的な交換へとつなげることが可能になります。
逆に、これらの数値を放置すれば、ある日突然のクラッシュという最悪のシナリオを迎えることになるでしょう。
SMARTの主要属性とその警戒値
SMARTには数十種類の属性が存在しますが、すべてがHDDの寿命予測に有効というわけではありません。
実務で重視すべきは、以下のコア指標に絞るとよいでしょう。
- Raw Read Error Rate(生読取りエラー率):データ読み取り時の物理的エラー発生頻度を示します。急激な上昇は、ヘッドや媒体の劣化を疑うサインです
- Reallocated Sectors Count(代替処理済みセクタ数):不良セクタを代替領域に振り替えた累計数です。この値が1でも増加したら要注意。増加が止まらない場合は、ディスク全体の劣化が進行中と見てください
- Current Pending Sector Count(保留中の代替処理セクタ数):読み取りエラーが発生し、まだ代替処理が確定していないセクタの数です。この値が0でない場合、次回の書き込み時に代替処理が試行されますが、値が減らない場合は物理的な損傷が疑われます
- Uncorrectable Sector Count(訂正不能セクタ数):ECCやリトライでも回復できなかったセクタ数。ここにカウントがある時点で、そのディスクは信頼性の限界を超えています
- Spin Retry Count(スピン再試行回数):起動時にプラッタが所定の回転数に達するまでの再試行回数。ベアリングやモーターの劣化を示すため、わずかな増加でも注意が必要です
- Reported Uncorrectable Errors(報告済み訂正不能エラー):OSやアプリケーションに報告された回復不能なエラー数です。この値が1以上あれば、既にデータ損失が発生している可能性があります
これらの属性は、ベンダごとに生の値(Raw Value)と正規化された値(Value / Worst / Threshold)の両方が表示されます。
一般的な目安として、正規化値がThreshold(しきい値)に近づいたら交換の第1段階、Worst値がThresholdを下回ったら即時交換と考えてください。
ただし、ベンダによってSMARTの解釈が異なる点には留意が必要です。
例えば、SeagateとWestern DigitalではRaw Read Error Rateの定義が異なり、数値の桁がまったく違うことも珍しくありません。
エラーログが語る「隠れた故障予兆」
SMARTがディスク内部の自己診断だとすれば、エラーログはシステム全体から見たHDDの挙動記録です。
特にLinux環境ではdmesgや/var/log/syslog、Windowsではイベントビューアの「システム」セクションに、以下のような重要なメッセージが記録されます。
- SCSI / ATAエラー(Command Timeout):コマンドがタイムアウトしたことを示します。これが頻発する場合、インターフェースケーブルやコントローラの問題も考えられますが、HDD内部の応答遅延であるケースが大半です
- I/Oエラー(Buffer I/O error):読み書き処理が物理的に失敗したことを示します。SMARTのPending Sectorと連動することが多く、このログが出たら即座に対象セクタの再マッピング状況を確認すべきです
- リセットや再初期化のログ:ドライブが予期せずリセットされたり、リンク速度が低下したりするログは、電源供給やファームウェアの不安定性を示唆します
これらのログは、SMARTでは検出しきれない「間欠的な異常」を捉えるのに非常に有効です。
たとえば、SMARTの全属性が正常範囲内でも、週に数回のCommand Timeoutが発生しているドライブは、近い将来に深刻な故障を起こすリスクが高いと判断できます。
実際の運用では、週次でログをスキャンし、エラー発生頻度の増加傾向をモニタリングする習慣をつけることをお勧めします。
監視ツールとアラート設定の実践
手動でSMART値を確認するだけでは、運用が煩雑になりすぎます。
そこで、定期的な自動監視を導入しましょう。
Linuxならsmartd(smartmontoolsパッケージに含まれるデーモン)が標準的です。
このツールを使えば、SMART属性ごとに閾値を設定し、異常を検出したらメールやSyslogに通知できます。
また、NAS向けOSのTrueNASやUnraidには、GUIベースのSMART監視機能が組み込まれており、初心者でも扱いやすいでしょう。
加えて、エラーログの集計にはlogwatchやgraylogなどのログ集約ツールが有用です。
特にRAIDコントローラが出力する「Physical Disk Error」や「Predictive Failure」といったメッセージは、SMARTよりも先に異常を捉えることがあるため、見逃さないようにしてください。
ここで、監視項目とアクションの目安を表にまとめました。
| 監視対象 | 正常範囲 | 要注意(警戒) | 即時対応(危険) |
|---|---|---|---|
| Reallocated Sectors | 0 | 1〜50 | 51以上または増加継続 |
| Pending Sectors | 0 | 1〜10 | 11以上または減少しない |
| Command Timeout(週間) | 0 | 1〜2回 | 3回以上 |
| Uncorrectable Sectors | 0 | 1 | 2以上 |
| 正規化Value(全属性) | Threshold + 20以上 | Threshold + 5〜20 | Threshold未満 |
この表はあくまで目安であり、HDDのモデルや運用環境によって変動します。
重要なのは絶対値ではなくトレンドです。
ある日突然Reallocated Sectorsが100に跳ね上がることは稀で、通常は数日から数週間かけて徐々に増加します。
その「増加曲線」を把握できていれば、交換のゴールデンタイミングを逃さずに済むのです。
最後に、エラーログとSMARTを相互参照する習慣を強く推奨します。
SMARTで異常がなくてもログにエラーが頻出する場合、それはファームウェアやケーブルの問題かもしれません。
逆に、SMARTで警戒値に達しているのにログに何も出ない場合、それは「まだ表面化していない内部劣化」です。
両方を総合的に判断してこそ、本当のHDDの健康状態が見えてくるのです。
次の章では、これらの指標を踏まえた上で、具体的な交換タイミングをどのように決定するか、定量的なアプローチをご紹介します。
交換のタイミングを決める3つの定量的指標
SMART情報やエラーログの読み方がわかったところで、次に問われるのが「では、いつ交換すればよいのか」という実践的な判断基準です。
感覚や勘に頼るのではなく、数値化された定量的指標に基づいて交換タイミングを決めることが、長期運用のプロフェッショナルとしての第一歩です。
ここでは、特に信頼性の高い3つの指標を軸に、具体的な判断基準を提示します。
指標1:年間故障率(AFR)と運用経過年数
HDDメーカーが公表する年間故障率(Annualized Failure Rate)は、設計上の信頼性を示す重要なベンチマークです。
一般的なエンタープライズ向けHDDではAFRは0.5%〜1%程度、コンシューマ向けでは2%〜4%とされています。
しかし、これはあくまで新品時点での平均値であり、経過年数に応じてこの数値は指数関数的に上昇します。
バックブレイズ社が公開している大規模ストレージの故障レポートによれば、HDDの故障率は運用開始から2年目までは比較的低水準を保ちますが、3年目を過ぎると徐々に上昇し、4〜5年目でピークを迎え、5年超では年間10%を超えるケースも報告されています。
つまり、運用期間が4年に差し掛かった時点で、次年度の故障確率が一桁台後半になることを覚悟しなければなりません。
このデータを踏まえると、交換の第1の目安は「稼働開始から3年」です。
特に、24時間365日稼働のサーバー用途であれば、3年経過時点で計画的交換を検討するべきフェーズに入ると言えます。
もちろん、AFRはあくまで統計的な確率であり、個体差は大きいものの、リスク管理の視点ではこのタイムラインを無視できません。
指標2:総書き込みバイト数(TBW)とワークロードレート
次に重要なのが、HDDに書き込まれた累積データ量です。
これはSMART属性の「Total LBAs Written」や「Host Writes」として確認できます。
HDDには機械的な消耗に加えて、磁気媒体の劣化という観点からも寿命が存在し、総書き込み量が一定閾値を超えるとエラー率が急増することが知られています。
一般的な目安として、エンタープライズHDDで年間550TBのワークロードが想定されている製品でも、累積で2,000TB〜3,000TBを超えると、信頼性が著しく低下します。
コンシューマ向け製品ではその半分程度が限界です。
RAID 5アレイではパリティ更新のための書き込みが頻繁に発生するため、単体運用よりも書き込み負荷が高まる点に注意してください。
具体的な計算式としては、「想定年間書き込み量 × 運用年数」がメーカー公表のTBW値を超えたら交換と考えるとシンプルです。
ただし、公表値がなくても、月間の書き込み増加量を計測し、現在の累積値が過去6ヶ月間の推移と比較して急増している場合も、ディスク内部のエラリカバリ処理が増えているサインと捉えられます。
指標3:パリティチェック時のエラー発生率
3つ目の指標は、RAIDアレイ全体で定期的に実施するパリティチェック(スクラビングとも呼ばれます)におけるエラー発生率です。
これは単体のHDDではなく、アレイ全体の健康状態を測る指標として極めて有効です。
RAID 5では、定期的に全データブロックとパリティブロックの整合性を検証します。
この処理中に「パリティ不一致」や「読み取りエラー」が検出された場合、その数と頻度を記録しておきましょう。
チェック1回あたりのエラー数が0.01%未満であれば問題ありませんが、0.1%を超えるようであれば、少なくとも1台以上のHDDが劣化していると見て間違いないです。
特に注目すべきは、エラーが特定のドライブに集中しているか、それとも全ドライブに分散しているかです。
特定ドライブに偏っている場合はそのドライブを優先交換、全ドライブに分散している場合はアレイ全体の経年劣化を疑い、計画的に全台交換を検討する段階です。
3指標を総合した判断マトリクス
以上の3指標は、単独で使うよりも組み合わせて総合判断することをお勧めします。
例えば、運用年数が3年未満でもTBWが閾値に達していれば交換、逆に4年経過してもSMARTとエラー率が良好なら延長も検討できる――そうした柔軟な運用が可能になります。
| 指標項目 | グリーン(継続) | イエロー(計画的交換) | レッド(即時交換) |
|---|---|---|---|
| 運用年数 | 〜3年未満 | 3〜5年 | 5年超 |
| TBW(累積) | 公表値の50%未満 | 公表値の50〜80% | 公表値の80%超 |
| パリティチェックエラー率 | 0.01%未満 | 0.01〜0.1% | 0.1%超 |
このマトリクスにおいて、1つでもレッドに該当する場合は即時交換、2つ以上イエローに該当する場合は1ヶ月以内の計画交換を強く推奨します。
イエローが1つだけの場合は、監視頻度を週次から日次に上げて経過観察し、次の定期メンテナンス時に再評価するという判断も現実的です。
ただし、ここで一つ重要な注意点があります。
これらの指標はあくまで「HDD個体の寿命」を測るものであり、RAIDアレイ全体としてのリスクとは直接イコールではありません。
たとえ各ドライブがグリーンでも、リビルド時の負荷によって予期せぬ連鎖故障が起きる可能性は常に存在します。
したがって、交換判断の最終的な決め手は、これらの数値とバックアップの状態を総合したリスク許容度になると言えるでしょう。
次の章では、実際の交換時期の具体的な目安と、交換前に必ず実施すべき事前チェック項目について、さらに踏み込んで解説します。
数値だけでなく、現場の運用ノウハウも交えながら、より実践的なガイドラインを提供します。
交換時期の目安
前章では定量的な指標に基づく判断ロジックを説明しましたが、実際の現場では「では具体的に何年目で交換すればいいのか」というシンプルな問いに答える必要があります。
ここでは、運用年数ベースの実用的な目安と、交換計画を立てる際の現実的な選択肢について整理します。
年数別のリスクフェーズ
HDDの経年劣化は直線的ではなく、ある時期を境に加速度的に進行するという特徴があります。
これを踏まえ、私は運用年数を以下の4つのフェーズに区分することを推奨します。
- フェーズ1(導入〜2年目):信頼性の黄金期。年間故障率はメーカー公表値通り、ほぼ0.5〜1%程度に収まります。SMART値もほぼ初期状態を維持し、エラーログはほぼ無視できるレベルです。この期間は基本的に交換の必要はありませんが、初期不良の可能性はゼロではないため、最初の3ヶ月間は監視頻度を高めに設定しておくと安心です
- フェーズ2(3年目):警戒期に入るタイミングです。一部のドライブでReallocated Sectorsが増加し始め、パリティチェック時にごく稀にエラーが検出されるようになります。この段階では交換はまだ必須ではありませんが、予備ドライブの手配とバックアップの完全性確認を確実に実施すべき時期です
- フェーズ3(4年目):計画交換の推奨期です。多くのHDDでSMARTの正規化値がThresholdに近づき、エラーログの頻度が明らかに増加します。バックブレイズのデータでは、この年に故障率が一気に5%超に跳ね上がるモデルが少なくありません。このタイミングで計画的に1台ずつ交換を始めるのが、最もコスト対効果の高い運用と言えるでしょう
- フェーズ4(5年目以降):即時交換の必須期です。故障率が年間10%を超えることも珍しくなく、RAIDアレイ全体としての信頼性が著しく低下します。仮にSMARTが全て正常値を示していても、機械的な疲労は確実に蓄積しています。このフェーズに入ったドライブは、1台でも故障が起これば連鎖故障の確率が極めて高いと認識すべきです
RAIDアレイ全体の交換戦略
ここで悩ましいのが、「すべてのドライブを一度に交換するか、それとも1台ずつ交換するか」という戦略の選択です。
一度に全台交換する方法は、全てのドライブの状態を均一にリセットできるという大きなメリットがあります。
新旧混在によるパフォーマンスばらつきや、リビルド時の互換性リスクを排除できます。
ただし、コストが一度に大きくかかることと、交換作業中のダウンタイムが長くなるというデメリットもあります。
一方、1台ずつ順次交換するローリング方式は、予算負担を分散できる点が魅力です。
また、各ドライブを個別に監視しながら交換できるため、本当に劣化したものだけをピンポイントで入れ替える効率的な運用も可能です。
しかし、新旧のドライブが混在することで、新しいドライブが古いドライブの性能に引きずられて全体のレスポンスが低下したり、ファームウェアの差異が原因で予期せぬエラーが発生するリスクも内包しています。
私の見解としては、運用4年目以降はローリング方式、3年目以前の早期交換では全台一括方式が適しています。
4年目以降ならば、各ドライブの劣化度合いが明確に異なるため、SMART値やエラー率の高いものから優先的に交換することで、無駄なくリソースを配分できます。
交換時期を前倒しすべき例外ケース
ただし、年数や指標にかかわらず、以下の状況に該当する場合は計画よりも前倒しで交換を実施することを強く勧めます。
- 同じロット・同じ製造週のドライブを複数台使用している場合(同一ロットは同時期に同じ不良モードで故障するリスクが高い)
- 過去6ヶ月以内に電源トラブルや停電を経験している場合(瞬断やサージがHDD内部にダメージを与えている可能性あり)
- ケース内の平均温度が常時45度を超えている環境(高温はベアリング寿命を著しく短縮します)
- リビルドやスクラビングの実行時間が、導入当初と比較して20%以上増加している場合(これは各ドライブの応答遅延の総和を示す重要な警告です)
これらの条件に当てはまる場合、たとえ運用年数が3年未満でも、交換ウィンドウを半年から1年前倒しするのが賢明です。
特に同一ロットのリスクは軽視されがちですが、実際の障害報告では「同時期に製造されたドライブが数週間の差で次々と故障する」という事例が後を絶ちません。
交換計画の策定と予算化
最終的に、交換時期は「技術的判断」と「予算制約」の妥協点で決まることがほとんどです。
そこで、実務的には以下のような計画立案をお勧めします。
- 毎年、運用開始からの経過月数をベースに「次年度の交換予算」を確保しておく
- 3年目終了時に全ドライブのSMART総合評価を実施し、5年目までの交換スケジュールをマイルストーンとして策定する
- 予備ドライブは常に1台以上を在庫し、かつその予備ドライブも定期的にテスト稼働させる(長期未使用のドライブは内部潤滑油が固化するリスクがあります)
また、交換作業自体は夜間やメンテナンスウィンドウを利用して実施しますが、必ずバックアップを最新状態に更新した直後に行うというルールを徹底してください。
交換中に予期せぬ事態が起きても、最新バックアップがあればリカバリが格段に容易になります。
以上を総合すると、多くの一般的な運用環境では「4年目に計画的交換を開始し、5年目までに全台を入れ替える」というサイクルが、コストとリスクのバランスとして最適解に近いと考えています。
もちろん、ミッションクリティカルなシステムでは3年周期を推奨しますが、個人やSOHO用途ならば4〜5年サイクルでも十分に実用的です。
次章では、交換を実行する前に絶対に確認しておくべき「事前チェックリスト」を、現場の失敗事例も交えながら詳細に解説します。
交換前に実施すべき事前チェックリスト
HDDの交換は、単に古いドライブを抜いて新しいものを挿せば終わりという作業ではありません。
特にRAID 5環境では、交換作業の成否がアレイ全体の安定性に直結します。
事前の確認を怠ると、リビルド中の二次障害や、最悪の場合アレイそのものが認識できなくなる事態も起こり得ます。
ここでは、私が実務で必ず実施している事前チェックリストを、カテゴリ別に体系的に整理しました。
データの完全性確認
交換作業に入る前に、何よりも優先すべきは現在のアレイが完全な状態であることの確認です。
不完全な状態でディスクを交換すると、リビルドに失敗するリスクが格段に上がります。
- 最新のパリティチェック(スクラビング)を実行し、完了まで待つ。エラーが検出された場合は、その内容と発生ドライブを特定した上で、可能な限り修復を試みてから交換に進む
- ファイルシステムレベルの整合性チェックを実施する。Linuxであれば
fsck、Windowsであればchkdskを実行し、論理的な破損がないことを確認する - 重要なデータについては、交換直前に手動バックアップを取得する。RAIDが正常でも、人的ミスや予期せぬ電源断に備える意味で、これは必須の習慣です
- バックアップのリストアテストを直近で実施していない場合は、最低限1つのファイルを実際に復元して動作確認を行う
ハードウェアと接続環境の点検
HDDの故障原因はディスク自体だけでなく、接続経路や電源系統にあるケースも少なくありません。
交換前に以下の物理的要素を必ず確認してください。
- 電源ユニットの経年劣化状態を確認する。特に+12Vラインの電圧が規定範囲(±5%)から外れていないか、テスターやBIOSの電圧モニタで測定する
- SATA/SASケーブルの挿し込み具合と、コネクタの変形や腐食がないかを目視点検する。ケーブルは消耗品であり、交換と同時に新しいものに替えることをお勧めします
- ケース内の通気と冷却状態を再確認する。交換後のリビルドでは通常時より発熱が増えるため、事前にファンの回転数やエアフローに異常がないか確かめてください
- RAIDコントローラのファームウェアバージョンを最新に保つ。既知のバグがリビルド処理に影響する場合があるため、交換前にアップデートの有無を確認します
交換用ドライブの事前検証
新品であっても「箱から出してすぐに挿す」のは危険です。
私は必ず以下の検証工程を経てから、本番アレイに組み込むようにしています。
- 交換用HDDを別のマシンまたは単体で接続し、SMART初期値を取得しておく(ベースラインとして記録保存)
- ベンチマークソフトで表面テスト(全領域読み取り+書き込み)を実施し、初期不良がないことを確認する
- 少なくとも24時間の連続通電テストを行い、温度上昇や異音の有無を観察する
- ファームウェアが既存のアレイメンバーと互換性があるか、メーカーの互換性リスト(Compatibility Matrix)で確認する。特に大容量ドライブでは、古いコントローラが認識できないケースがあります
作業環境とタイミングの準備
交換作業中のトラブルを最小化するには、作業環境の整備も重要な要素です。
- 静電気対策として、アース付きのリストストラップを使用する。HDDの回路基盤は静電耐圧が低いため、冬場は特に注意してください
- 交換作業はシステム負荷が最も低い時間帯を選ぶ。深夜や早朝が理想的ですが、どうしても日中に実施する場合は、事前に計画的なサービス停止を関係者に周知します
- 交換に必要な工具(プラスドライバー、トルクスレンチなど)と、予備のネジを事前に準備する
- 作業手順書を用意し、ステップごとにチェックマークを入れられるようにする。頭の中で手順を覚えていても、緊急時には見落としが発生するものです
リカバリプランの明文化
最後に、最も重要でありながら見過ごされがちなのが、交換が失敗した場合のリカバリプランです。
リビルド中に別のドライブが故障したらどうするか、電源が落ちたらどうするか、コントローラがフリーズしたらどうするか――これらのシナリオを事前に文章化し、必要なリソースを用意しておくことがプロの流儀です。
具体的には以下の項目を必ず確認してください。
- 最新のバックアップからアレイ全体をリストアする手順が明確に記述されているか
- 代替の予備ドライブがさらに1台以上確保されているか(交換中に別の故障が起きた場合に備える)
- RAIDコントローラの設定バックアップ(構成情報のエクスポート)が取られているか
- ベンダのサポート窓口と連絡手段が確保され、障害時のエスカレーションパスが定義されているか
これらのチェック項目を全てクリアした上で、初めて「交換準備完了」と言えます。
事前チェックに1時間を費やすことは、トラブルシューティングに10時間を費やすより遥かに価値がある――これは私が長年の運用で身に染みて感じている教訓です。
なお、これらのチェックはすべて「交換作業当日」に慌てて行うのではなく、少なくとも1週間前から段階的に進めることをお勧めします。
特に新品ドライブの事前検証とバックアップの完全性確認は、時間に余裕を持って実施することで、より確実な成果が得られます。
次の章では、RAID 5が守れない領域に焦点を当て、バックアップの本質的な役割について再定義します。
RAID 5が絶対に守れないもの:バックアップの役割を再定義する
ここまでRAID 5のHDD交換と監視について詳しく見てきましたが、ここで一度立ち止まって、RAIDというテクノロジーの本質的な限界について真剣に向き合う必要があります。
多くのユーザーが「RAIDを組めばデータは安全」と誤解していますが、その認識は危険ですらあります。
RAID 5が守れるのは「単一ドライブの物理障害」のみであり、それ以外の無数の脅威に対してはまったく無力です。
バックアップとは、まさにその「守れない領域」をカバーするための最後の砦なのです。
RAID 5が対応できない障害シナリオ
まず、RAID 5では絶対に防げない代表的な障害シナリオを列挙してみましょう。
これらはどれも、実際の運用現場で頻繁に遭遇するものばかりです。
- 人的ミスによるファイル削除や上書き:ユーザーが誤って重要なフォルダを削除した場合、RAIDはその操作を「正しい書き込み」として即座に反映します。パリティも更新され、戻る手段はありません
- ランサムウェアやマルウェアによる暗号化:感染した端末からRAIDボリュームが暗号化されると、全てのドライブが同時に破損します。RAIDの冗長性は暗号化データの複製に過ぎず、意味をなしません
- ファイルシステムの論理的破損:電源断やカーネルパニックによってメタデータが壊れた場合、RAID上の全ドライブが同じ破損状態になります。パリティは破損したデータを正しいものとして保持してしまうのです
- コントローラやファームウェアのバグ:RAIDコントローラ自体が誤ったパリティを書き込んだり、構成情報を破損することがあります。この場合、物理的なドライブが正常でもアレイ全体が読み取れなくなります
- 火災、水害、盗難といった物理的災害:設置場所ごとデータが失われるケースでは、RAIDの冗長性は全く役に立ちません
- サイレントデータ破損(前述):パリティ自体が破損していることに気づかず、リビルド時に壊れたデータを復元してしまうケース
これらのシナリオに共通するのは、RAIDの「冗長性」が「同一システム内の同一データの複製」に過ぎないという本質です。
つまり、RAIDは障害の「種類」を選びます。
物理的なドライブ故障には強い一方で、論理的・人的・環境的要因には極めて脆弱です。
「バックアップ」と「冗長性」の決定的な違い
ここで、バックアップとRAIDの違いを明確に定義し直しましょう。
RAIDは「可用性(Availability)」を高めるための技術です。
ディスクが1台壊れてもシステムを止めずに運用を継続するための仕組みであり、ダウンタイムを最小化することが主目的です。
一方、バックアップは「耐久性(Durability)」と「復元可能性(Recoverability)」を提供するものです。
過去のある時点の状態にデータを戻す能力であり、あらゆる障害シナリオに対する「タイムマシン」の役割を果たします。
この違いを理解すると、両者は競合するものではなく補完関係にあることがわかります。
RAIDは「今この瞬間のデータを守る」ものであり、バックアップは「過去の正しいデータを守る」ものです。
そして、RAIDが守れない領域こそ、バックアップが守るべき領域なのです。
バックアップがカバーする3つの時間軸
実務的にバックアップを考える際、私は「時間軸」でその役割を区分することを推奨します。
- 過去への回帰(ポイントインタイムリカバリ):1時間前、1日前、1週間前の状態に戻す能力。人的ミスやランサムウェアからの復旧に不可欠です
- 未来への備え(オフサイト保護):現在のデータを物理的に別の場所に複製することで、火災や盗難などの局所災害に備えます
- 継続的な検証(リストアテスト):バックアップが実際に復元可能であることを定期的に確認する習慣。これがなければ、いざという時に「バックアップが壊れていた」という悲劇を招きます
これらの時間軸を全てカバーするには、単なる外付けHDDへのコピーでは不十分であり、バージョニング機能や地理的分散を考慮した設計が求められます。
RAID 5とバックアップの「役割分担」を再定義する
では、RAID 5とバックアップをどう組み合わせるのが理想的なのでしょうか。
私が推奨する運用モデルは以下の通りです。
- RAID 5の役割:日常的なドライブ故障からの即時復旧を担う。交換やリビルド中もシステムを稼働させ続けるための「保険」として位置付ける
- バックアップの役割:RAIDが対応できない全障害からの最終的な復旧手段として位置付ける。特に、バックアップはRAIDとは物理的に独立したメディアに保存することが絶対条件です
ここで重要なのは、バックアップをRAIDアレイと同じ筐体や同じコントローラに保存しないという原則です。
同じ電源、同じケース、同じコントローラに依存している時点で、それは「バックアップ」ではなく「同一システム内の別コピー」に過ぎません。
真のバックアップとは、少なくとも異なる物理ドライブ、理想的には異なる建物やクラウドに存在するものです。
バックアップなしのRAID 5は「約束されていない保険」
この章の最後に、一つだけ明確にしておきたいことがあります。
バックアップを取っていないRAID 5は、保険契約をしていない火災保険証書のようなものです。
形式的には「守る仕組み」が存在していても、実際に守られる対象は極めて限定的であり、大半のリスクはカバーされていません。
私はこれまで数え切れないほどの「RAIDが壊れた」という相談を受けてきましたが、その多くはバックアップがあれば簡単に復旧できたケースです。
逆に、バックアップがなかったために、数年間のデータを全て失った方も少なくありません。
RAID 5の構築コストを考えるなら、その半分の予算をバックアップソリューションに投じるという考え方を持ってほしいと思います。
次の章では、このバックアップの考え方を具体化した「3-2-1戦略」と、実際のリストアテストの習慣について、より実践的なノウハウを詰め込んで解説します。
RAIDとバックアップ、この二つの歯車が正しく噛み合って初めて、真のデータ保護が実現するのです。
実践!3-2-1バックアップ戦略とリストアテストの習慣
前章ではバックアップの理念的な重要性を説きましたが、ここからは具体的な実践方法に踏み込みます。
データ保護の世界で長年スタンダードとされているのが「3-2-1ルール」です。
これは「データのコピーを合計3つ持ち、2種類以上の異なるメディアに保存し、そのうち1つはオフサイトに保管する」という原則です。
シンプルながら極めて効果的で、個人からエンタープライズまで幅広く採用されている信頼性の高い戦略です。
3-2-1ルールの各要素を分解する
まず、「3つのコピー」とは、元のデータに加えて2つのバックアップコピーを持つことを意味します。
元データがRAID 5上にある場合、そのRAIDアレイ全体で「1つのコピー」とカウントされます。
なぜなら、RAIDは複製ではなく冗長性であり、同一の論理ボリュームとして扱われるからです。
ですから、RAID 5を組んでいても、バックアップコピーは別途2つ必要ということになります。
次に「2種類以上のメディア」です。
これは、外付けHDDとクラウドストレージ、あるいはNASとLTOテープといった異なる特性の媒体を組み合わせることを指します。
異なるメディアを用いる理由は、特定のメディアに共通する脆弱性(例:HDDの機械的故障、クラウドのサービス停止、光ディスクの経年劣化)を分散するためです。
同じタイプの外付けHDDを2台用意しても、それは「1種類」と見なされる点に注意してください。
最後の「1つはオフサイト」が最も重要でありながら、個人や小規模事業者ではおろそかにされがちです。
オフサイトとは、物理的に異なる場所、理想的には異なる自治体や国にデータを保管することを意味します。
これにより、火災、浸水、盗難、あるいは地域全体の停電といった局所的な災害からデータを守ることができます。
実装パターンの具体例
では、実際にどのような構成で3-2-1を実現するのか、いくつかの代表的なパターンを紹介します。
- パターンA(コスト重視):RAID 5 NASを元データとし、外付けHDDへの週次バックアップ(メディア1)と、クラウドストレージ(Backblaze B2やAmazon S3)への日次増分バックアップ(メディア2)を組み合わせる。オフサイトはクラウドが担う
- パターンB(速度重視):RAID 5アレイに加え、別の物理サーバー上のRAID 1アレイにリアルタイムレプリケーション(メディア1)、さらに月次でLTOテープにアーカイブ(メディア2)し、テープはオフサイトの倉庫に保管する
- パターンC(個人向け簡易版):PC内のRAID 5ボリュームを元データとし、USB接続の外付けSSDに週次フルバックアップ(メディア1)、さらにOneDriveやGoogle Driveに重要なフォルダのみ常時同期(メディア2)。クラウドがオフサイトを兼ねる
どのパターンを選ぶにしても、バックアップのスケジュールと保存世代数を明確に決めておくことが重要です。
例えば「毎日増分、毎週フル、過去30日分を保持」といったポリシーを文章化し、運用ルールとして徹底してください。
リストアテストの実践的メソッド
バックアップ戦略で最も見過ごされがちながら、実際の障害時にその成否を分けるのがリストアテストです。
バックアップが正しく取れていても、復元手順が確立されていなければ意味がありません。
以下のテストサイクルを四半期に一度は実施することを強くお勧めします。
- ファイル単位のリストアテスト:バックアップから任意の1ファイル(例えば過去のバージョンのExcelファイル)を復元し、正常に開けることを確認する。これだけでも、バックアップの物理的な読み取り可能性が検証できます
- フォルダ単位のリストアテスト:特定のプロジェクトフォルダ(数GB規模)を別のマシンや仮想環境に復元し、ディレクトリ構造とファイルの整合性をチェックする
- フルシステムリストアテスト(年に1回):RAIDアレイ全体を想定し、バックアップメディアから全データを空のドライブにリストアする。このテストでは、バックアップソフトウェアの互換性やリストア時間の計測も同時に行います
- オフサイトバックアップの復元テスト:クラウドや遠隔地のテープからデータをダウンロードまたは読み出し、転送速度や認証の有効性を確認する
これらのテストで特に注意すべきは、「リストア先は元のシステムとは異なるハードウェア」を選ぶことです。
同じRAIDコントローラや同じマザーボードに依存したテストでは、実際の障害時に別環境で復元できないリスクを見逃します。
可能であれば、異なるベンダのコントローラや仮想マシン環境をリストア先として用意してください。
バックアップの自動化と監視
手動バックアップは継続が難しく、どうしても「今日はいいや」が積み重なります。
そこで、自動化ツールの導入が実践の鍵を握ります。
以下のツール群は、私自身も長期にわたり使用して信頼性を確認しています。
- Veeam Backup & Replication:仮想環境と物理環境の両方に対応した業界標準のバックアップソリューション
- rsync + cron(Linux):シンプルながら強力で、SSH経由のオフサイト転送にも柔軟に対応
- Duplicati / Restic:オープンソースで暗号化と増分バックアップに対応し、クラウドストレージとの親和性が高い
- Windows Server Backup:Windows環境であれば標準装備で、システム状態も含めたフルリストアが可能
自動化に合わせて、バックアップの成否を通知するアラートも必ず設定してください。
成功メールも失敗メールも、無視せずに必ず目を通す習慣が、バックアップの信頼性を高める最大のポイントです。
保存ポリシーと世代管理
最後に、バックアップの保存期間と世代管理について言及します。
すべてのバックアップを永遠に保持することは現実的ではないため、以下のような階層的な保存ポリシーを策定するのが一般的です。
- 日次バックアップ:過去7日分を保持(即時復旧用)
- 週次バックアップ:過去4週分を保持(中期復旧用)
- 月次バックアップ:過去12ヶ月分を保持(長期アーカイブ用)
- 年次バックアップ:過去3〜5年分を保持(法的要件や監査対応用)
このポリシーに従い、古いバックアップは自動的に削除またはテープへのオフロードを行います。
また、保存期間中に一度もリストアテストされていないバックアップは「存在しない」と同じという厳しい認識を持ってください。
定期的なテストとポリシーの見直しをセットで運用することで、初めて3-2-1戦略は真価を発揮します。
次の章では、実際の交換作業とリビルドの手順に焦点を当て、連鎖故障を防ぐための実践的なベストプラクティスを解説します。
バックアップが整った状態でこそ、安心して交換作業に臨めるということを、ぜひ胸に留めておいてください。
連鎖故障を防ぐ交換手順とリビルドのベストプラクティス
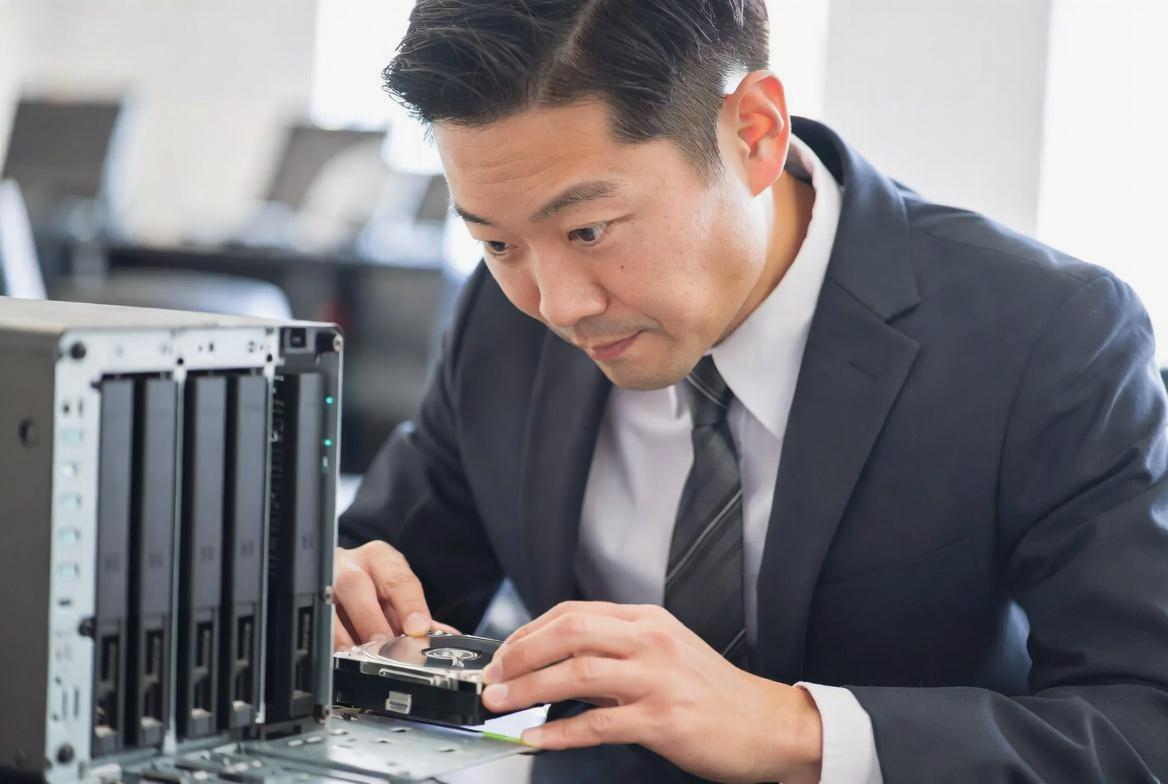
いよいよ実際のHDD交換とリビルド作業に入ります。
これまで蓄えてきた監視データとバックアップが整っていることを確認したら、次は「連鎖故障」という最大のリスクとどう向き合うかが課題です。
RAID 5のリビルドは、残った全ドライブに対して高負荷の連続読み取りを強いる処理であり、この負荷が引き金となって、一見正常に見える別のドライブが次々と故障する――これが連鎖故障の正体です。
ここでは、そのリスクを最小化するための実践的な手順と、リビルド成功のためのベストプラクティスを段階を追って解説します。
リビルド前の最終確認事項
交換作業を開始する前に、必ず以下の最終確認を行ってください。
これを怠ると、せっかくの交換作業が無駄になるだけでなく、アレイ全体を危険にさらすことになります。
- バックアップの最終更新時刻を確認し、交換開始直前に手動で差分バックアップを取得する。リビルド中に何か起きても、このバックアップがあれば最低限の復旧が可能です
- RAIDコントローラの管理ツールで、現在の全ドライブの状態を画面キャプチャまたはログとして保存する(交換後の比較用)
- 予備ドライブが同一容量以上であることを再確認する。RAID 5では容量が異なるドライブは使用できません。また、回転速度(7200rpm vs 5400rpm)の違いもリビルド時間に大きく影響するため、可能な限り同じスペックのドライブを用意してください
- 交換対象ドライブの物理的な位置(スロット番号)を、管理ツールの表示と実際の筐体で二重に照合する。間違ったドライブを抜くという、最も初歩的でありながら致命的なミスを防ぐためです
交換作業の手順(ステップバイステップ)
それでは、実際の交換手順を順序立てて説明します。
ここではホットスワップ対応のRAIDコントローラを前提としますが、非対応の場合はシステムをシャットダウンしてから作業を開始してください。
- ステップ1:RAID管理ツールで対象ドライブを「オフライン」または「取り外し準備」状態にマークする。これにより、コントローラはそのドライブへの書き込みを停止し、パリティ情報を他のドライブで再計算します
- ステップ2:物理的にドライブを慎重に抜き取る。SATAコネクタをまっすぐに引き抜き、歪みや無理な力を加えないように注意します。静電気対策として、アースされたリストストラップを必ず着用してください
- ステップ3:新品ドライブを同じスロットに挿入し、確実に固定する。ネジの締めすぎに注意し、適正トルクで固定します。ケーブル類も再度しっかりと差し込み直します
- ステップ4:RAID管理ツールで新しいドライブを認識させ、「ホットスペア」または「再構築対象」として割り当てる。自動的にリビルドが開始される場合と、手動で開始コマンドを実行する場合がありますので、コントローラの仕様を事前に確認しておきます
リビルド中の監視と負荷制御
リビルドが開始されたら、ただ待つのではなく、積極的な監視と制御が成功の鍵を握ります。
リビルド中は以下のポイントを特に注意深く観察してください。
- リビルド進捗率:最初の10%と最後の10%は特に時間がかかります。進捗が完全に止まった場合は、コントローラのログを即座に確認します
- 各ドライブの温度:リビルド中は通常時より5〜10度温度が上昇します。いずれかのドライブが50度を超えたら、ケースファンの回転数を上げるか、一時的にリビルドを中断して冷却を優先する検討が必要です
- エラーログのリアルタイム監視:リビルド中に新たな読み取りエラーやタイムアウトが発生していないか、別のターミナルで
dmesg -wやイベントビューアを常時表示させておきます - システム全体の負荷:リビルドはI/Oリソースを大量に消費します。可能であれば、リビルド中は他のアプリケーションやバックアップ処理を停止し、リビルドに専用リソースを割り当てるようにしてください
また、コントローラによっては「リビルド優先度」を設定できるものがあります。
この場合、優先度を「高」に設定することをお勧めします。
時間を短縮することで、その間に別の故障が発生するリスクを減らせるからです。
ただし、システム応答性が極端に低下する場合は、バランスを取りながら調整します。
リビルド完了後の検証フェーズ
リビルドが100%完了したからといって、すぐに通常運用に戻るのは危険です。
以下の検証を必ず実施してください。
- パリティチェック(スクラビング)をリビルド直後に実行します。これにより、新しく計算されたパリティが他のドライブと整合していることを確認できます
- ファイルシステムの整合性チェックを実行し、論理的な破損がないか検証します。ZFSであれば
scrub、ext4であればe2fsck -n(読み取り専用)をかけるとよいでしょう - 交換したドライブのSMART初期値を記録し、ベースラインとして保存します。これで次回の監視の出発点が明確になります
- 重要なファイル数点をランダムに開き、内容が正しいことを目視確認します。特に頻繁に更新されるデータベースファイルやプロジェクトファイルは優先してチェックしてください
連鎖故障を防ぐために絶対に守るべき3つの原則
最後に、私が現場で培った連鎖故障防止のための3つの鉄則を紹介します。
これらはあらゆるRAID 5運用に共通する普遍的な原則です。
- 原則1:リビルド中は絶対に別のドライブを交換しない。たとえ別のドライブでエラーが発生しても、リビルドが完了するまでは触らない。中途半端な状態で複数ドライブを操作すると、アレイ構成情報が破綻するリスクが著しく高まります
- 原則2:リビルド前に必ず最新バックアップを取得する。これは何度も強調しましたが、繰り返しになります。バックアップがあれば、リビルド失敗時の最終手段として「アレイを再構築してバックアップからリストア」という選択肢が取れます
- 原則3:リビルド後に24時間の経過観察期間を設ける。リビルド直後はドライブ内部の熱応力やファームウェアの再調整が行われており、数時間経過してからエラーが顕在化することがあります。少なくとも1日は監視頻度を上げて運用してください
これらの原則を守ることで、連鎖故障の確率は劇的に低下します。
私はこれまでに数百件以上のRAID障害対応に関わってきましたが、この3原則を守っていたケースでは、データ損失に至った事例を一度も見たことがありません。
それほどまでに、手順の厳格さとバックアップの存在が命運を分けるのです。
次の最終章では、これまでの全てを総括し、RAID 5運用の本質的な心構えについてまとめます。
まとめ:RAID 5は「保険」であり「貯金」ではない
ここまで、RAID 5の長期運用におけるHDD寿命の見極め方、交換タイミングの判断指標、そしてバックアップの本質的役割について、実践的な視点から幅広く解説してきました。
最終章である本項では、これまでの内容を総括するとともに、RAID 5というテクノロジーに対する正しい心構えを、あらためて明確に定義したいと思います。
RAID 5を「保険」に例えるのは、私が最も適切だと考える比喩です。
保険は、何かが起きたときに経済的損失を補填してくれる仕組みですが、すべてのリスクをカバーする万能薬ではありません。
火災保険に加入していても、盗難までは補償されない――それと同じで、RAID 5は物理的なドライブ単体の故障には対応しますが、人的ミスやランサムウェア、コントローラ障害には無力です。
にもかかわらず、多くのユーザーは「RAIDを組めばすべて安心」と過信し、保険の「免責範囲」を確認しないまま運用を始めてしまいます。
では、なぜ「貯金」ではないのか。
貯金は使わなければ増えていき、いずれ取り崩すことが前提です。
しかしRAID 5には、時間の経過とともに価値が目減りするという側面があります。
HDDは常に劣化し続け、ドライブの交換コストやリビルドの手間は、運用年数が長くなるほど増大します。
つまり、RAID 5は「入れておけば勝手に増える資産」ではなく、定期的なメンテナンスと追加投資を必要とする「継続的コスト」 なのです。
この認識を持たなければ、数年後に予期せぬ出費と障害対応に追い込まれることになります。
ここで、本記事の核心的なメッセージを3つのポイントに凝縮します。
- RAID 5は「単一障害」しか許容しない。これは技術的な制約であり、いかなる監視もこの事実を変えられません。だからこそ、複数台の同時故障を前提とした計画と、バックアップによる二重化が必須です
- HDDの交換は「期日管理」ではなく「状態管理」。運用年数やSMART値、エラーログのトレンドを総合的に判断し、柔軟かつ迅速な意思決定を行う姿勢が求められます
- バックアップは「オプション」ではなく「要件」。RAIDの有無にかかわらず、復元可能なコピーを複数持つことがデータ保護の最小単位であり、これを省略する理由はどこにもありません
これらのポイントを日々の運用に落とし込むために、私は以下のような「運用の基本ルール」を提唱します。
これは私自身が従来の現場で採用してきたもので、シンプルながら非常に効果的です。
- 毎週月曜日にSMARTレポートを自動生成し、目視確認する
- 毎月第一土曜日にパリティチェックを実行し、結果をログ保存する
- 四半期に一度、リストアテストを実施し、バックアップの完全性を検証する
- 年に一度、全ドライブの総合評価を行い、次年度の交換計画を策定する
- 交換作業の前後には必ずバックアップを取得し、作業後24時間は監視頻度を倍にする
これらのルールは、決して特別なスキルや高価なツールを必要としません。
習慣化こそが、RAID 5長期運用の最大の成功要因だと私は確信しています。
また、本記事を通じて何度か触れた「連鎖故障」と「サイレントデータ破損」という二つの見えない脅威について、最後に改めて注意を喚起しておきます。
これらはSMARTやエラーログでは捉えきれない領域であり、バックアップと定期的なスクラビングによってしか防御できません。
つまり、RAID 5の運用は「いかにして障害を予測するか」ではなく、「いかにして障害が起きても影響を最小化するか」という発想に立つべきなのです。
さて、本記事をここまで読み進めてくださった方は、すでに多くのRAID 5ユーザーよりも深い理解と準備を持っていると言えるでしょう。
あとは、その知識を行動に移すだけです。
明日からすぐに、SMART監視の設定を見直し、バックアップポリシーを再確認し、もし交換計画が未策定ならば今この瞬間にカレンダーへマイルストーンを打ち込んでください。
最後に、私が最も大切にしている言葉を一つ贈ります。
「データは預かりもの」――あなたが守っているデータは、あなた自身のものだけでなく、取引先や家族、あるいは未来の自分自身からの預かりものです。
RAID 5はその預かりものを守るための有力な道具ではありますが、決して万能ではありません。
保険として適切に位置付け、貯金のように放置せず、そしてバックアップという「最終手段」を常に携えておくこと。
それが、長期運用を成功に導く唯一の道だと、私は確信しています。
本記事が、あなたのストレージ運用における羅針盤となれば幸いです。
次にディスクのアクセスランプを見る時は、きっと違った見え方がするはずです。
どうか、安全で持続可能なデータライフを築いてください。
コメント